當“問 AI”比“搜一下”更快:品牌要如何被看見
當用戶直接問 AI,品牌競爭就從搜尋排名變成答案佔位。真正危險的不是排名下降,而是 AI 根本沒把你納入候選答案;品牌需要用可信內容、外部口碑和可抓取結構重新建立存在感。
Topics
4摘要
當用戶直接問 AI,品牌競爭就從搜尋排名變成答案佔位。真正危險的不是排名下降,而是 AI 根本沒把你納入候選答案;品牌需要用可信內容、外部口碑和可抓取結構重新建立存在感。
當”問AI”比”搜一下”更快:品牌要如何被看見
幾年前還很難想像這樣的場景:一個人想買空氣炸鍋,開啟手機,沒有去淘寶或者百度搜”空氣炸鍋推薦”,而是直接問了句”適合兩口之家、預算500以內的空氣炸鍋有哪些”,然後得到一段已經組織好、帶著理由的回答,連對比都幫他做完了。
這事現在每天都在發生。無論是ChatGPT、Perplexity,還是百度、Google搜尋結果裡冒出來的AI摘要,越來越多的人在決策的最後一步,問的不是搜尋引擎,而是一個”會說話”的模型。這對品牌來說不是一個遙遠的趨勢預警,而是一個已經在悄悄改變流量結構的現實——你的內容寫得再好,如果AI在生成答案時壓根沒提到你,使用者可能從頭到尾都不知道你存在過。
這篇文章想聊聊:這件事到底意味著什麼,以及一個普通品牌、不依賴大團隊、也能做點什麼。
一、搜尋結果消失之後,競爭發生在哪裡
傳統搜尋引擎的遊戲規則大家都熟:關鍵詞、外鏈、結構化標籤,排進前幾位,等使用者點進來。這套邏輯沒有完全失效,但它的”地盤”正在被擠佔——當用戶在搜尋框上方直接看到一段AI生成的總結性答案,很多人根本不會再往下滑去看那十條藍色連結。
更微妙的變化是,AI給出的答案往往是”綜合”出來的,它可能同時參考了三五個不同來源,然後用自己的語言重新組織一遍。這意味著哪怕你的內容質量很好,使用者讀到的也未必是你的原文——而是被AI轉述、壓縮、甚至悄悄忽略掉的版本。
所以問題變成了兩層:第一,AI在生成答案時,有沒有”看到”你;第二,看到了之後,願不願意把你當作值得提及的來源。這兩層缺一不可,而且做法不完全一樣。
二、AI挑內容的眼光,和搜尋引擎不是一套標準
老派SEO信奉的是”匹配”:使用者搜什麼詞,你的頁面裡就該出現什麼詞,出現的密度、位置都有講究。這套思路放到AI身上基本失靈了,因為AI不是在”匹配字串”,它是在”理解意思”。
打一個簡單的比方。假設有兩篇文章都在講”如何選購意式咖啡機”。第一篇嚴格按照SEO套路寫,標題裡塞滿關鍵詞,正文反覆重複”意式咖啡機推薦""意式咖啡機怎麼選”這類短語,但內容鬆散,沒有真正給出判斷依據。第二篇文章可能標題樸素,但開篇就直接說清楚了”預算決定看泵壓還是看半自動/全自動""家用和商用的核心區別在哪”,並且給出了具體型號的取捨理由。
如果你是那個需要從一堆資料裡提煉答案、再講給使用者聽的AI,你會更願意”轉述”哪一篇?答案不難猜——後者的邏輯清晰、觀點明確、能被幹淨地摘出來用,前者讀起來像在繞圈子。
這也是為什麼內容優化會涉及語言模型優化(Language Model Optimization)、生成式引擎優化(GEO)和答案引擎優化(AEO)等相關方向。這些概念相互關聯,但側重點並不完全相同;它們都強調內容不僅要準確,還要易於理解、便於擷取,並能經得起追問。具體來說,有這麼幾件事是共通的:
把答案放在最前面,而不是讓使用者讀完三段背景介紹才看到重點;用真實資料、案例、可驗證的細節支撐觀點,而不是停留在形容詞層面;定期回去檢查舊內容是否還準確,過時的資訊對AI來說和”錯誤”沒什麼區別;以及,把一個主題講透,而不是淺淺地覆蓋十個相關話題——AI更容易把一篇”講透了”的文章當作權威來源,而不是十篇都講了一半的文章。
三、幾個主流AI模型,“脾氣”還真不一樣
雖然原理類似,但不同AI產品在抓取資訊、決定引用誰這件事上,行為差異挺明顯,值得分開來看:
|
平台 |
資訊來源特點 |
對品牌內容的影響 |
|---|---|---|
|
ChatGPT(OpenAI) |
訓練資料有明確截止時間,部分功能可聯網檢索補充最新資訊 |
內容的”可讀性”和”時效性”都重要,過時或表述模糊的內容容易被繞過 |
|
Perplexity |
非常依賴即時網頁檢索,習慣把引用來源直接列出來,也整合了Reddit、Yelp等平台的資料 |
在論壇、點評網站上的真實討論和口碑,直接影響是否被引用 |
|
Google AI Overviews(Gemini能力的體現) |
直接長在搜尋結果頁頂部,本質是Google搜尋生態的延伸 |
傳統SEO積累的權重依然有用,結構化資料和事實性內容更容易被摘要採用 |
|
Claude(Anthropic) |
偏好邏輯嚴謹、來源可信的內容,對”聽起來像行銷文案”的內容會更謹慎 |
教育性強、論證紮實、不誇大其詞的內容相對更容易被採信 |
這張表格只是一個粗略的畫像,AI產品迭代速度很快,今天的行為特徵半年後未必還準確——這件事本身也提醒我們,盯著某一家平台死磕沒有意義,更值得花精力的,是把內容本身打磨得經得起任何一個”挑剔的讀者”(不管是人還是模型)推敲。
四、要不要讓AI爬蟲進門,這是個真實的取捨
這是個常被忽略,但其實挺關鍵的問題:你的網站要不要主動允許AI公司的爬蟲來抓取內容?
允許的好處很直接——內容被收錄進AI的知識庫或者即時檢索範圍後,被引用、被提及的機率自然更高,長期看也有助於建立”權威來源”的形象。但代價也是真實存在的:有些AI產品在引用時並不總是清楚標註來源,你辛苦寫的內容可能被悄悄”消化”進答案裡,卻沒人知道是你寫的;如果你的內容本身是付費課程、專業報告這類需要變現的資產,被免費抓取訓練,對生意是有直接影響的。
這不是一個有標準答案的問題,更接近於”看你是誰、你的內容是什麼性質”。下面這張圖是一個簡化的判斷起點,不是嚴格的規則,但可以幫你把問題拆開來想:
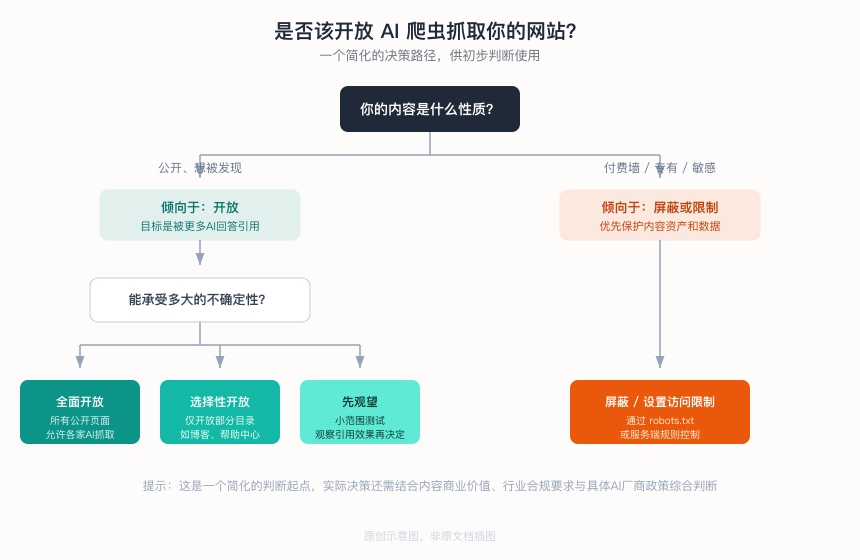
簡單說,如果你的內容本身就是想被儘可能多人看到的——部落格、產品介紹、幫助文件,那開放基本是順理成章的;如果內容是你的核心資產、靠它直接賺錢,那至少要先想清楚再決定,而不是預設”開放”。技術上,大多數網站可以通過robots.txt或者服務端規則,對不同的AI爬蟲單獨設定許可權,做到”選擇性開放”,不是非黑即白的二選一。
五、具體能做的事,落地到一個普通團隊身上是什麼樣
講了這麼多原理,回到”我明天上班該幹什麼”這個問題上。
先看看自己現在的處境。 在動手之前,花點時間去問問AI一些和你業務相關的真實問題,看看自己有沒有被提到、提到的語氣怎麼樣、競爭對手又是怎麼被描述的。這一步經常被跳過,但跳過它,後面所有的優化都是在猜。市面上像HubSpot的AI Search Grader這類工具可以批次化地做這件事,自己手動多問幾次AI也能摸出個大概。
把長篇內容拆解成”能被直接摘走”的小塊。 一篇五千字的攻略,如果中間夾雜著大量背景鋪墊,AI很難從裡面精準提煉出某個具體問題的答案。更有效的做法是用清晰的小標題、FAQ形式的段落,把每一個子問題都獨立寫成一段能”自給自足”的回答——讀者跳到那一段就能看懂,不需要讀完前面所有內容。
舉個實際一點的例子。 假設你是一家做企業協作軟體的公司,過去的內容策略可能是寫一篇”十大團隊協作工具評測”,努力把自己排在前面。現在更值得做的,可能是針對”遠端團隊怎麼避免會議太多""跨時區團隊怎麼同步進度”這類具體場景,各寫一篇結構清晰、給出明確做法的文章——這種內容更容易被AI當作”權威解答”直接引用,而不是被歸類為”又一篇帶貨軟文”。
走出官網,因為AI也在”聽”別處的聲音。 Reddit上的真實討論、垂直論壇、應用商店和點評網站上的評價,都是不少AI產品明確會參考的資訊源。一個長期在這些地方有真實、正面聲音的品牌,天然比只在自己部落格裡自賣自誇的品牌更容易被相信。認真回覆差評、參與真實的行業討論,這件事的回報可能比再寫十篇推廣文章更實際。
別忽視傳統媒體和PR。 不少AI公司已經和一批老牌新聞媒體、出版機構達成了內容授權合作,這意味著被這些渠道報道,間接也會增加在AI回答中”被提到”的機會。比起把所有預算都砸在自己的內容農場上,偶爾爭取一次有分量的媒體報道,性價比可能更高。
定期回去更新,而不是寫完就扔。 一篇三年前發布、資料早已過時的文章,對AI來說和”不存在”差別不大,甚至可能因為內容矛盾而被判定為不可靠。把”內容審計”做成一個常規動作——哪怕只是每季度檢查一次核心頁面的資料是否還準確——比不斷生產新內容更划算。
六、傳統搜尋沒退場,不必把雞蛋放進一個籃子
值得提一句的是,並不是所有使用者都已經習慣了用AI替代搜尋,傳統搜尋引擎依然承載著相當大的真實流量,尤其是帶著強烈購買意圖、需要比價或者本地服務的搜尋場景。
好訊息是,讓內容對AI友好和做好傳統SEO,這兩件事的底層要求其實高度重合——內容真實、結構清晰、來源可信,對哪種”讀者”都成立。真正需要調整的,往往只是表達方式:標題更像一個真實的提問,答案更靠前,段落更能獨立成立。這些改動成本不高,但回報會同時體現在兩條渠道上,不需要為了迎合AI而完全推翻原有的內容體系。
寫在最後
AI搜尋帶來的最大變化,可能不在技術層面,而在於品牌第一次真正失去了對”使用者怎麼看到我”這件事的完全掌控權。這聽起來有點讓人不安,但換個角度看,它其實也在悄悄淘汰那些靠堆砌關鍵詞、內容空洞的玩法——長期專注於把內容寫真實、寫清楚、寫到經得起追問的品牌,反而會在這場轉變裡顯得更從容。
技術會一直變,今天分析的這幾家平台的具體行為半年後可能就不一樣了,但”這段內容是不是真的解決了別人的問題”這件事,從來沒有過時過。
文中的對比表格和決策示意圖為根據公開行業資訊整理後的原創整理,並非任何特定文件的插圖複製。