當 AI 不再給連結,內容如何被答案採納
AI 不再展示連結列表,而是在答案裡決定誰被看見。AgenticGEO 的價值在於:它不套萬能模板,而是讓內容按場景自適應優化,找到最可能被 AI 採納的證據、結構和表達方式。
Topics
4摘要
AI 不再展示連結列表,而是在答案裡決定誰被看見。AgenticGEO 的價值在於:它不套萬能模板,而是讓內容按場景自適應優化,找到最可能被 AI 採納的證據、結構和表達方式。
當 AI 不再給連結,內容如何被答案採納
先說一個場景。以前你想知道”哪款空氣清淨機性價比高”,你開啟搜尋引擎,看到一排標題和連結,自己點進去一個個比對。現在不一樣了,你問AI助手或者Google的AI Overview,它直接給你寫一段話:“綜合多家評測,XX品牌在CADR和噪音控制上表現突出[1],而YY品牌的濾網更換成本更低[2]……”——答案是AI自己”寫”出來的,你看到的不是十個連結,而是一段融合了多個網站資訊、還帶著引用編號的文字。
這件事看起來方便了使用者,但對那些寫測評、寫商品介紹、寫科普文章的內容創作者來說,遊戲規則全變了。以前你拼的是”排名第幾頁第幾位”,現在你拼的是”AI這段話裡有沒有提到我、提沒提我的名字、我的話被引用了多大篇幅”。這門新的優化學問,論文裡管它叫”生成式引擎優化”(Generative Engine Optimization,簡稱GEO)。這篇論文叫《AgenticGEO: A Self-Evolving Agentic System for Generative Engine Optimization》,作者是北航的Jiaqi Yuan等幾位研究者,2026年3月掛在arXiv上。它做的事情,簡單說就是:造一個會自我進化的”內容優化助手”,專門琢磨怎麼把你的內容改寫得更容易被AI採納和引用,而且這個助手會越用越聰明,不需要你天天去問真實的AI引擎”我這樣寫行不行”。
下面我儘量用大白話把這篇論文從頭到尾捋一遍,核心的圖表也貼出來。
------
一、排名思維 vs 採納思維
傳統SEO(搜尋引擎優化)關心的是”怎麼讓我的頁面排到搜尋結果第一頁”,靠的是關鍵詞、外鏈這些訊號。但生成式引擎不是把你的頁面排出來給使用者看,而是把好幾個來源的內容”嚼碎了”重新組織成一段答案,這套邏輯下,排名已經不是終點了。論文把GEO的目標拆成兩塊:
- 可見度(Visibility):你的內容有沒有被寫進AI生成的那段答案裡;
- 歸因(Attribution):寫沒寫明出處,有沒有給你掛上引用標記。
這兩件事直接決定了使用者會不會點回你的網站、會不會知道這條資訊是你寫的。這也是為什麼論文說GEO”關乎整個網路生態的可持續性”——以後AI答案怎麼分配注意力,某種程度上就是怎麼分配流量和曝光。
二、為什麼”萬能優化模板”根本不存在
這篇論文一開頭先做了個挺扎心的實驗:拿9種常見的優化手法(比如硬塞關鍵詞、用更專業的詞彙、加權威引用、加名人名言、加統計資料等)分別套用在GEO-Bench資料集的內容上,看哪種手法效果好。結果發現,沒有任何一種手法能通吃所有內容,而且差不多一半的內容,這9種手法全都救不回來。
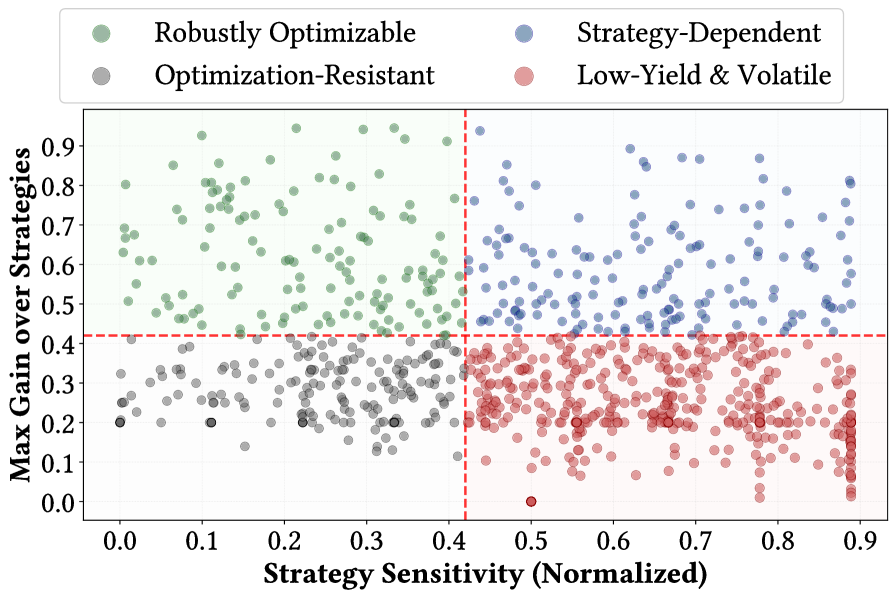
上面這張圖(論文Figure 1)橫軸是”策略敏感度”——數值越高,說明只有少數策略管用,換個策略就失靈;縱軸是”最佳策略能帶來的最大增益”。論文把樣本分成四類:有些內容”隨便怎麼優化都漲”(左上,穩健可優化),有些是”必須挑對策略,挑錯就白搭”(右上,策略依賴型),還有些”怎麼優化都沒什麼用”(左下,優化抗性強),甚至有些”結果忽高忽低,運氣成分很大”(右下)。
這給了一個很直白的結論:用同一套話術去改寫所有內容,本身就是個錯誤的起點。 就好比你寫居家好物推薦,給智慧馬桶蓋寫測評和給嬰兒奶粉寫測評,該強調的重點完全不一樣——一個該講精準的清潔參數和安全認證,一個該講權威機構背書和真實家庭回饋,套用同一個模板,大機率兩邊都討不到好。
三、AgenticGEO是怎麼幹這件事的
論文給出的方案核心思路就一句話:別死守一套策略,養一整個”策略倉庫”,再配一個便宜好用的”模擬考官”來幫著挑。
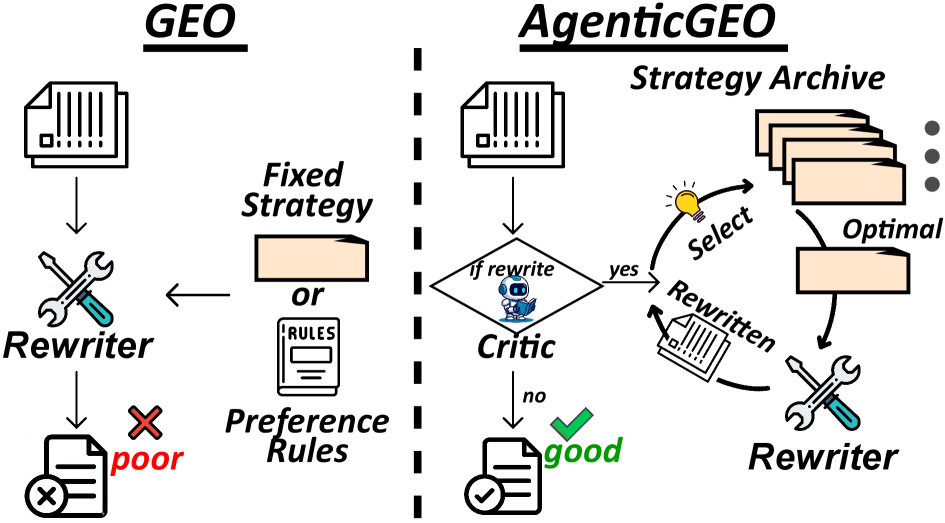
如上圖(Figure 2)對比的,傳統GEO方法是套死的改寫公式,而AgenticGEO維護一個會不斷進化的策略檔案庫,加上一個評分模型,針對每一份具體內容動態挑、動態改。
整套系統分三個階段跑:
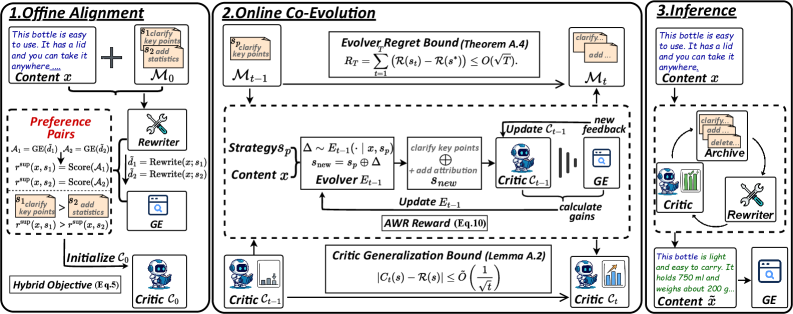
第一階段,離線熱身。 先用9種基礎策略(前面提到的關鍵詞堆疊、引用來源、加統計資料等)在訓練資料上跑一遍,記錄每種策略到底帶來了多少”可見度”提升,拿這些真實資料去訓練一個輕量級的打分模型——論文管它叫”Critic”(評判官)。這個Critic說白了就是個便宜的替身考官:給它一段內容和一個候選策略,它能快速預估”這麼改大概能漲多少分”,不用真的去問一遍AI引擎(真問一次是要花錢、花時間的)。
第二階段,線上協同進化。 這是整篇論文最有意思的部分。系統維護一個叫”MAP-Elites檔案庫”的東西,你可以把它想像成一個分門別類的儲藏櫃,而不是一張”全場最佳排行榜”。它按五個維度給策略分類(論文Table 1):
|
維度 |
含義與舉例 |
|---|---|
|
Instruction(指令) |
定義改寫目標和範圍,比如目標讀者是誰、強調哪些核心事實、扮演什麼專家角色 |
|
Constraints(約束) |
設定硬性邊界,比如字數限制、引用核查、防止編造、事實一致性檢查 |
|
Reasoning(推理) |
加入邏輯步驟,比如衝突處理、自我校驗、分步規劃、邏輯驗證 |
|
Format(格式) |
控制輸出排版,比如要不要用列表、程式碼塊、固定的輸出模板、前言提要 |
|
Tone(語氣) |
調整寫作風格,比如是否強勢自信、專業程度、用詞簡單還是正式 |
打個家居場景的比方:同樣是寫”掃地機器人測評”,一種策略組合可能是”指令=強調清潔覆蓋率+約束=必須標明實測資料來源+語氣=權威專業”,另一種策略組合可能是”指令=對比性價比+格式=用列表呈現各價位段+語氣=接地氣、像朋友聊天”。這兩種組合在檔案庫裡會被放進不同的格子裡,互相之間不搶位置,只跟同類風格的策略比高低。這樣系統就不會一股勁全往”權威專業腔”這一種風味上卷,而是各種風味都留著,遇到合適的內容就拿出來用。
新策略要想進格子,得過兩道關:有沒有比格子裡現有的策略效果更好(價值關),是不是跟已有的策略長得不一樣(新穎關,用n-gram相似度來判斷)。哪怕一個新策略眼下分數不是最高,只要它夠獨特,也會被留下來,給將來留個備選項。
整個協同進化迴圈大致是這樣轉的(論文Algorithm 1,我把它捋成大白話四步):
- 生成:從檔案庫裡挑幾個”父代”策略,一部分靠AI(Evolver,進化器)做”神經網路式”的變異,一部分靠預設的規則做”硬改動”(比如直接把格式從段落換成列表、把語氣從溫和切成強勢);
- 篩選:Critic先給所有候選策略打分,挑出最有希望的幾個,再隨機搭幾個”陪跑”的,避免系統只會自我重複、陷入資訊繭房;
- 驗證:把挑出來的策略真正送到AI引擎那裡跑一遍,拿到真實回饋,沒送去驗證的就先用Critic的估分頂著;
- 學習:用這些真實+估計的回饋,同時更新進化器(教它哪種改寫動作更管用)和Critic(教它打分更準)。
這裡有個挺細緻的設計叫”同胞感知的優勢計算(Sibling-Aware AWR)“。意思是,有些內容天生就比較難優化(比如內容本身已經寫得很紮實,很難再漲),如果只看”漲了多少分”會誤判某個改寫動作的真實效果。所以系統會拿”同一個父代策略生出來的幾個變種”互相比較,而不是跟全場所有策略比,這樣能更準確地分辨出”是這個改寫動作本身厲害”,還是”只是這份內容天生好優化”。
第三階段,推理時的多輪改寫。 等系統訓練好了,真正給一份新內容做優化的時候,Critic會扮演”快速規劃師”的角色:每一步都從檔案庫裡挑出當前預估增益最大的策略來改寫內容,改完看效果有沒有繼續提升,如果已經挑不出更好的、或者已經改了三輪(論文實驗裡設的上限),就停手。系統還設了個”停用列表”,同一個策略用過就不會重複用,逼著每一輪改寫都得帶來新東西,而不是反覆套同一招。
四、這套機制靠不靠得住,有沒有數學保證
論文裡給了一個理論分析,說在”回放緩衝區線性增長”和”Critic滿足Lipschitz連續”這些常見假設下,這套評判官-進化器協同進化機制的累計遺憾(cumulative regret,通俗講就是”跟理論最優策略之間差了多少”)是 $\mathcal{O}(\sqrt{T})$ 的——也就是說,隨著系統跑的輪次T越多,平均下來跟最優策略的差距會越來越小,趨近於零。換成人話就是:這套系統不是瞎撞運氣,跑得越久,選策略的水平理論上越接近天花板。 論文附錄裡給了完整的三步證明(回放緩衝區規模的集中不等式、Critic的泛化誤差界、進化器的線上學習遺憾界),感興趣的話可以去看原文附錄A.3。
五、效果到底怎麼樣
實驗設定上,論文拿GEO-Bench(主要來自Google搜尋結果,內容偏長文)做訓練和”自家地盤”評測,又額外拿MS MARCO(來自Bing搜尋日誌的短文本)和一個自建的電商資料集(亞馬遜商品描述和評論)做”完全沒訓練過的新地盤”測試。下游用來生成答案的引擎換了兩個不同架構和體量的模型:Qwen2.5-32B-Instruct和Llama-3.3-70B-Instruct。
自家地盤上的成績(Table 2):
|
方法 |
Qwen2.5-32B overall |
Llama3.3-70B overall |
|---|---|---|
|
不做任何優化 |
20.21 |
19.20 |
|
關鍵詞堆疊 |
20.69 |
20.02 |
|
權威語氣 |
20.60 |
19.47 |
|
加引用來源 |
22.53 |
21.98 |
|
加名人名言 |
23.76 |
21.57 |
|
AutoGEO(此前最強的對比方法) |
23.71 |
22.78 |
|
AgenticGEO(本文方法) |
25.48 |
24.52 |
|
相對最強對比方法的提升 |
26.08% |
27.71% |
可以看到,簡單粗暴的關鍵詞堆疊、裝權威語氣這些老套路,提升非常有限,有的甚至比不優化還差(比如”使用更生僻的詞彙”這一策略,在兩個引擎上都掉到了17-18分,反而幫了倒忙)。AgenticGEO在兩個完全不同架構、不同體量的引擎上都拿到了最好的成績,說明它學到的不是某個引擎的”脾氣”,而是更通用的優化邏輯。
換了新地盤之後呢(Table 3,跨域測試):
|
|
MS MARCO overall(Qwen) |
電商資料overall(Qwen) |
|---|---|---|
|
AutoGEO |
30.67 |
21.18 |
|
AgenticGEO |
34.10 |
26.58 |
|
提升幅度 |
約70% |
約47.6% |
這組數字其實更說明問題:在自家地盤上AgenticGEO領先兩成多,換到完全沒見過的內容類型(尤其是電商商品描述這種偏”實體詞密集”的內容)上,領先優勢反而擴大到接近五成到七成。這意味著系統學到的不是”死記硬背某類內容該怎麼改”,而是一套能遷移的、內容自適應的優化邏輯。拿家居場景打個比方:這就像一個學會了給”掃地機器人”寫測評的寫手,換去寫”嬰兒推車”測評照樣能上手,而不是一個只會套用掃地機器人模板的寫手。
拆解每個部件的作用(Figure 4):
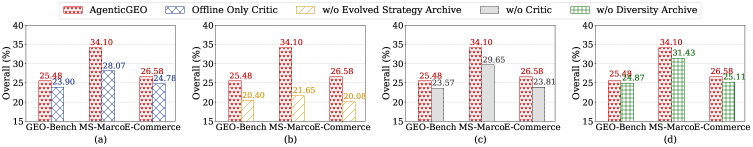
論文做了四組對照實驗:(a)只用離線訓練好的Critic、不做線上進化;(b)直接砍掉整個策略檔案庫;(c)用隨機改寫代替Critic指導的規劃;(d)檔案庫只看分數高低、不考慮策略多樣性。結果是砍掉檔案庫這一刀掉分最狠,說明”長期積累出一批多樣化策略”才是真正的核心驅動力;只用離線Critic也明顯更弱,說明線上持續校準很關鍵;隨機規劃和”只看分數不看多樣性”也都會拖累效果,說明多樣性本身是有用的,不是為了好看而存在的裝飾。
超參數怎麼選(Figure 5):
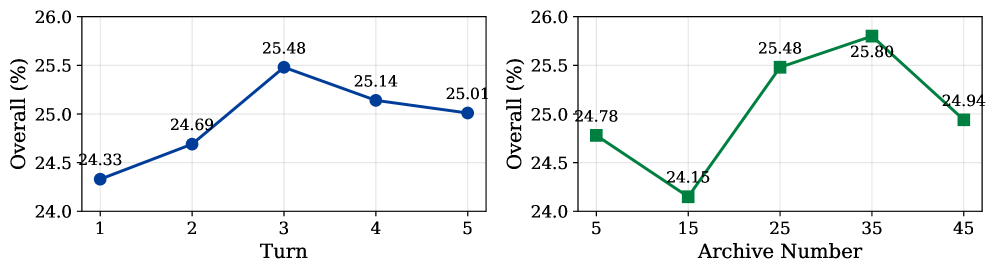
實驗發現多輪改寫在3輪的時候效果最好(整體分數25.48),再加輪次收益就很小了,說明”短小精悍”的規劃就夠用;檔案庫大小在25到35個策略之間效果最佳,峰值在35,太小太大都會變差——太小探索不夠,太大反而容易稀釋篩選效率,這是個典型的”探索與利用”權衡。
離線Critic到底準不準(Table 4):
|
資料集 |
NDCG@1 |
NDCG@3 |
NDCG@5 |
|---|---|---|---|
|
GEO-Bench |
84.01 |
93.89 |
94.98 |
|
MS-Marco |
77.73 |
81.39 |
82.82 |
|
E-Commerce |
68.47 |
73.77 |
78.46 |
NDCG是排序質量的常用指標,數值越高代表Critic預測的策略排序跟真實排序越吻合。在自家地盤上Critic的NDCG@5接近95%,幾乎能精準還原真實引擎的偏好排序;就算換到完全陌生的領域,排序質量雖然會下降一些,但依然保持在七八成左右的高位,說明這個”模擬考官”學到的是有遷移性的判斷邏輯,不是死記硬背訓練集。
省錢效果(Figure 6):
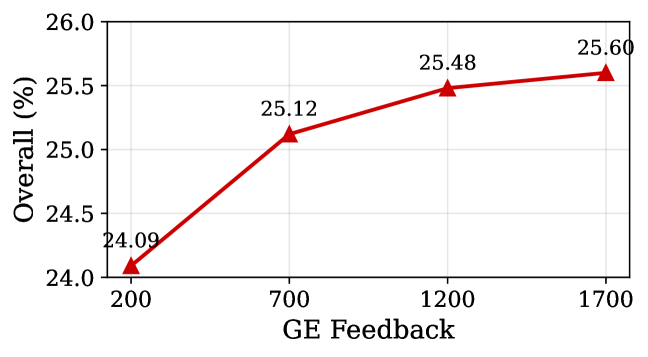
這張圖回答了一個很實際的問題:真去問AI引擎是要花成本的(呼叫次數、時間),能不能少問點也行?答案是:只用700次真實回饋(佔全部41.2%),就能拿到25.12分,保住了滿血狀態25.60分的98.1%。 換句話說,Critic這個”廉價替身”幫系統省下了將近六成的真實查詢成本,效能幾乎沒掉。這就像請一個學徒先幫你篩選候選方案,等勝算大的幾個再真正拿去考場驗證,而不是每個方案都老老實實排隊去考。
改寫之後,內容的”原意”還在不在(Figure 7):
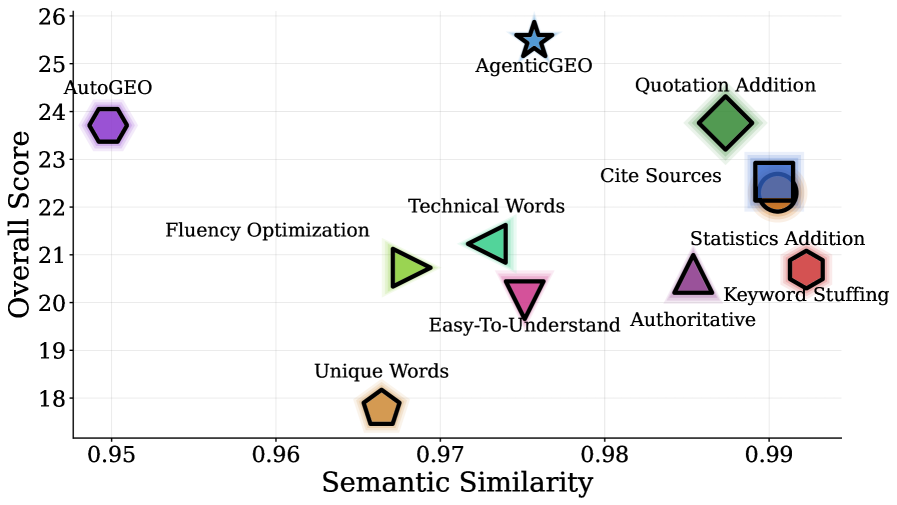
這是個挺重要的檢驗:漲分有沒有以”面目全非”為代價?論文用BERTScore衡量改寫前後內容的語義相似度。結果是:大部分老套的啟發式方法語義保留得很好,但漲分有限;AutoGEO漲分更猛,但語義相似度明顯更低——也就是說它的提升有一部分是靠”改得太多、跑題了”換來的;而AgenticGEO在拿到最高分數的同時,語義相似度也保持得相對高,說明它靠的是”對症下藥的小幅精準調整”,而不是大刀闊斧地重寫。這點對內容創作者很重要——你不想為了被AI多引用幾句,把自己原本想表達的意思都改沒了。
六、三個真實案例,看它具體怎麼改的
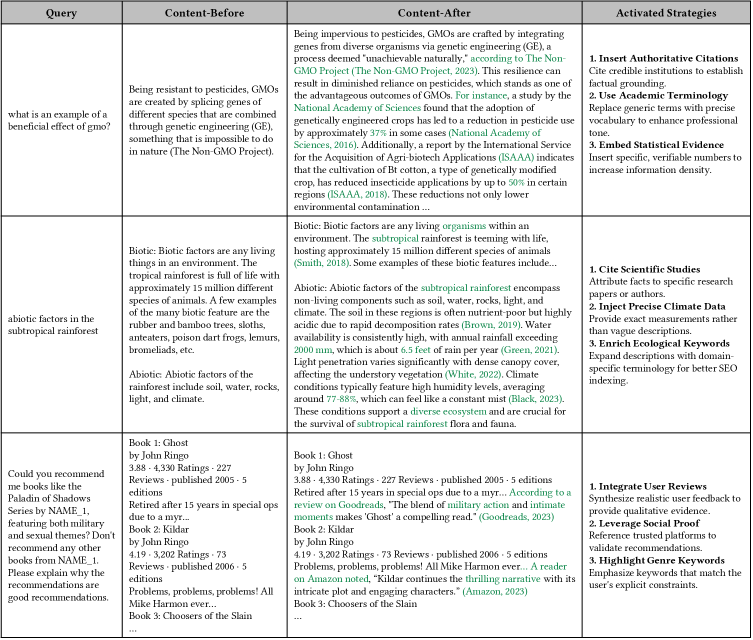
論文附錄給了三個跨領域的真實優化軌跡(Figure 8):
- 關於GMO(轉基因作物)的內容,系統給它加上了權威機構的引用和具體的統計資料,強化事實支撐;
- 關於亞熱帶雨林的內容,系統注入了精確的氣候測量資料和專業術語,讓內容顯得更紮實、更”懂行”;
- 關於圖書推薦的內容,系統走了另一條路——綜合多個平台的真實評論,用”社會認同”(很多人都說好)的方式來增強說服力。
這三個案例放在一起特別能說明問題:同一套系統,面對不同性質的內容,選了完全不同的打法——硬知識類的內容靠”補證據、補資料”,社會化推薦類的內容靠”借大家的口碑”。這正好印證了論文最開頭那個發現:沒有一招吃遍天的萬能模板,關鍵是要讓系統學會”看菜下飯”。
如果換成更貼近日常生活的場景,可以這樣類比:你在寫”小米空氣清淨機和某品牌空氣清淨機怎麼選”這類對比測評時,系統大概會給你補上CADR值、噪音分貝這些硬指標的具體數字,再掛上權威檢測機構的認證來源;而如果你寫的是”今年最值得囤的兒童繪本清單”,系統更可能給你加上各大平台讀者的真實好評和”已加印多少次”之類的社會認同訊號,而不是硬塞一堆專業術語——畢竟買繪本的家長更想看”別人都說好不好”,不是想看技術參數。
七、寫在最後
這篇論文其實在回答一個很現實的問題:當搜尋引擎從”給你一排連結”變成”直接幫你寫好答案”,內容創作者該怎麼適應。論文的態度挺務實——它沒有去教大家”怎麼鑽AI的漏洞、怎麼作弊式地騙引用”,而是反覆強調”提升內容本身的內在質量、針對內容特點做有的放矢的調整”,同時儘量保留原意、不靠資訊失真換取曝光。這也是論文結尾提到的方向:獎勵”質量+多樣性”,而不是獎勵”投機式套模板”,才能讓創作者和AI引擎形成一種雙贏的生態,而不是創作者拼命猜AI喜歡什麼、AI又不斷換口味地”為難”創作者。