內容創作者如何被 AI 答案引用
關鍵詞堆砌在生成式搜尋裡開始失靈,真正提高引用機會的是來源、資料、引言和清晰結構。KDD 2024 GEO 論文證明:小網站也可能靠內容質量,在 AI 答案中搶回可見度。
Topics
4摘要
關鍵詞堆砌在生成式搜尋裡開始失靈,真正提高引用機會的是來源、資料、引言和清晰結構。KDD 2024 GEO 論文證明:小網站也可能靠內容質量,在 AI 答案中搶回可見度。
內容創作者如何被 AI 答案引用
原文:Pranjal Aggarwal、Vishvak Murahari、Tanmay Rajpurohit、Ashwin Kalyan、Karthik Narasimhan、Ameet Deshpande,《GEO: Generative Engine Optimization》,KDD 2024。arXiv:2311.09735
這篇論文想解決什麼問題
過去三十年裡,搜尋引擎重塑了人類獲取資訊的方式,但它做的事情其實很”笨”:輸入關鍵詞,返回一串相關網頁連結,剩下的閱讀和判斷工作全部留給使用者。大語言模型出現後,情況變了。BingChat、Google 的 SGE、Perplexity.ai 這類產品不再只是”列連結”,而是直接檢索多個網頁、綜合資訊、生成一段帶引用的自然語言答案。論文把這類系統統一稱為生成式引擎(Generative Engine,GE)。
生成式引擎對使用者和開發者都是好事——使用者更快拿到答案,開發者獲得更高的使用者粘性和商業價值。但有一個群體被晾在了一邊:網站和內容創作者。傳統搜尋引擎好歹還會把使用者導流到網站本身,生成式引擎直接在答案裡把內容”消化”完了,使用者可能根本不需要點開原始連結,網站的曝光和流量因此被削弱。更麻煩的是,生成式引擎是黑箱、且產品迭代極快,創作者完全不知道自己的內容是如何被檢索、摘要、引用的,也沒有任何工具幫他們提升曝光。
作者由此提出了生成式引擎優化(Generative Engine Optimization, GEO)——某種意義上是”SEO 的下一代”——第一個面向內容創作者、專門針對生成式引擎可見度的優化框架。為了能夠嚴謹評測各種優化手段,他們還構建了一個萬級規模的查詢基準 GEO-bench。實驗顯示,合適的優化手段能讓一段內容在生成式引擎答案裡的可見度提升最多達到 40%,並且這種提升在真實產品 Perplexity.ai 上同樣能復現(最高 37%)。
生成式引擎到底是怎麼運作的
論文先給生成式引擎做了一個形式化定義。一個生成式引擎接收使用者查詢 $q_u$(以及可選的個性化資訊 $P_U$),輸出一段自然語言回答 $r$:
$$f_{GE} := (q_u, P_U) \rightarrow r$$
它內部由兩部分組成:
- 一組生成模型 $G=\{G_1, G_2, ..., G_n\}$,各自負責不同子任務,比如改寫查詢、生成摘要、撰寫最終回答;
- 一個搜尋引擎 $SE$,根據查詢返回一組候選來源 $S=\{s_1, s_2, ..., s_m\}$。
論文中描述的典型工作流程(對應原文 Figure 2,與 BingChat 當時的設計接近)分為三步:
- 查詢改寫:一個改寫模型 $G_{qr}$ 把使用者原始問題拆解成若干個更適合檢索的子查詢;
- 檢索與摘要:這些子查詢被送進搜尋引擎,取回一批排序後的來源網頁,再由摘要模型 $G_{sum}$ 給每個來源生成摘要;
- 生成回答:回答生成模型 $G_{resp}$ 綜合所有摘要,產出一段連貫的回答,並在句子層面標註引用來源。
由於大模型存在幻覺問題,引用機制至關重要:理想情況下,回答裡每一句話都該有支撐它的引用(高引用召回),同時每條引用都應該真的能支撐它所標註的那句話(高引用精確度)。論文重點研究的是這種”一問一答”的單輪生成式引擎,但也在附錄裡討論了可以擴展到多輪對話場景的情形。
給”可見度”下一個新定義
SEO 的核心邏輯很簡單:網頁在搜尋結果裡的平均排名越靠前,曝光和流量就越大。但這個邏輯搬到生成式引擎裡完全不成立——因為生成式引擎根本不會給你列一份排好序的連結清單,它是把多個來源的資訊揉在一段文字裡,引用可能出現在任意位置,篇幅有長有短,呈現方式也千差萬別。
所以論文提出了一套專為生成式引擎設計的”曝光度(impression)“指標體系,設計時遵循三條原則:對創作者有實際意義、可解釋、容易被普通創作者理解。具體包括:
1. 詞數佔比(Word Count):某個來源被引用的句子總詞數,佔整段回答總詞數的比例。如果一句話同時被多個來源引用,詞數就在這些來源間平分。直覺很樸素——一個來源被引用得越”長”,它在答案裡的存在感就越強。
2. 位置加權詞數(Position-Adjusted Word Count):在詞數佔比的基礎上,給排在回答靠前位置的引用句子加權,權重隨位置呈指數衰減。這是因為大量點選率研究表明,使用者對搜尋結果的關注度隨排名呈冪律式下降——同樣的邏輯被沿用到了生成式引擎回答的句子順序上。
3. 主觀印象指標(Subjective Impression):前兩個指標都是”客觀計數”,但曝光度還有很多沒法靠數單詞解決的維度,比如這條引用跟使用者問題到底有多相關、它對整段回答的”貢獻”有多大、內容是否獨特、讀者主觀上會不會覺得這條引用”顯眼”、使用者點開它的可能性有多大、呈現的資訊是否多樣化等。論文用 G-Eval(一種基於 GPT 打分、目前公認效果較好的 LLM 自動評測方法)讓模型針對七個子維度分別打分,再做歸一化處理,使其與位置加權詞數具有可比的均值和方差。
這套指標體系比”看排名”複雜得多,但也更貼近生成式引擎回答的真實結構——原文 Figure 3 用一個對比圖直觀展示了傳統搜尋結果頁(線性排序列表)和生成式引擎回答(引用穿插在一段文字裡、長短位置各異)之間的差異,正是這種差異催生了重新設計可見度指標的必要性。
九種可以落地的 GEO 優化策略
確定了”怎麼衡量”,接下來是”怎麼提升”。論文用大語言模型對網站原文做改寫,提出並驗證了 9 種策略,每種策略本質上是一個函式 $f: W \rightarrow W’$,把原始網頁內容 $W$ 變成優化後的內容 $W’$:
|
策略 |
做法 |
|---|---|
|
權威化(Authoritative) |
把文風改得更具說服力、更權威 |
|
增加統計資料(Statistics Addition) |
儘量用量化資料替代定性描述 |
|
關鍵詞堆疊(Keyword Stuffing) |
像傳統 SEO 那樣,塞入更多與查詢相關的關鍵詞 |
|
引用來源(Cite Sources) |
加入來自可信來源的引用 |
|
增加引言(Quotation Addition) |
加入權威人士/機構的直接引語 |
|
通俗化(Easy-to-Understand) |
簡化語言,降低理解門檻 |
|
提升流暢度(Fluency Optimization) |
改善文本的行文流暢性 |
|
獨特用詞(Unique Words) |
增加不常見、獨特的措辭 |
|
專業術語(Technical Terms) |
增加專業/技術性詞彙 |
其中關鍵詞堆疊、引用來源、增加引言這三種需要補充一定的新內容,其餘六種只是在不引入額外資訊量的前提下改善”呈現方式”。為了公平比較,每個查詢都會隨機挑一個候選來源網站,分別用九種策略各改寫一遍,再觀察曝光度的變化。
怎麼做評測:GEO-bench
由於此前完全沒有公開的、面向生成式引擎場景的查詢資料集,作者自己攢了一個——GEO-bench,包含 1 萬條查詢,來自 9 個不同來源,按 8000/1000/1000 劃分為訓練/驗證/測試集:
- MS MARCO、ORCAS-I、Natural Questions:來自 Bing/Google 的真實使用者查詢,是搜尋引擎研究領域常用的”老三樣”;
- AllSouls(牛津大學 All Souls 學院的論述題)、LIMA(需要推理與創作能力的高難度問題)、Davinci-Debate(辯論類問題)、Perplexity.ai Discover(平台熱門趨勢查詢)、ELI5(要求”像給五歲小孩解釋”一樣簡單作答的複雜問題)、GPT-4 生成查詢(覆蓋科學、歷史等多領域,兼顧導航型/交易型等不同查詢意圖)。
整體上,查詢分佈儘量貼近真實場景:80% 是資訊型查詢,交易型和導航型各佔 10%。每條查詢都配有 Google 搜尋返回的前 5 個來源網頁的清洗後文本。此外,作者用 GPT-4 給每條查詢打上 7 類標籤(難度、查詢性質、領域、具體主題、敏感性、使用者意圖、答案類型),並人工核驗了標註的精確率和召回率。最終,GEO-bench 覆蓋 25 個領域(藝術、健康、遊戲等)、9 種資料來源、7 種分類維度,是目前規模和多樣性都相當可觀的生成式引擎專用基準。
實驗中使用的生成式引擎”原型”沿用了此前研究(Liu et al., 2023)的兩步法設計:第一步用 Google 檢索 Top-5 來源,第二步用 gpt-3.5-turbo 按統一的提示詞模板(原文附錄給出了完整 prompt,核心要求是”僅依據給定搜尋結果作答,且每句話後面都要緊跟內聯引用”)生成回答。為降低隨機性,每條查詢在溫度 0.7 下采樣 5 次取平均。
核心結果:哪些策略真正有效
下表是論文的主表(對應原文 Table 1),展示了 9 種策略在兩大類指標上相對於”不做任何優化”基線的絕對得分(數值已歸一化,使所有引用的曝光度加總為 1,再乘以常數方便閱讀;具體數值越大代表曝光度越高):
|
方法 |
位置加權詞數(總分) |
主觀印象(均值) |
|---|---|---|
|
不優化(基線) |
19.3 |
19.3 |
|
關鍵詞堆疊 |
17.7 |
20.2 |
|
獨特用詞 |
20.5 |
20.4 |
|
通俗化 |
22.0 |
20.5 |
|
權威化 |
21.3 |
22.9 |
|
專業術語 |
22.7 |
21.4 |
|
提升流暢度 |
24.7 |
21.9 |
|
引用來源 |
24.6 |
21.9 |
|
增加引言 |
27.2 |
24.7 |
|
增加統計資料 |
25.2 |
23.7 |
幾個明顯的結論:
- 傳統 SEO 的招數在這裡基本失效。關鍵詞堆疊不僅沒有提升,在”位置加權詞數”這一項上反而比不優化還低,說明生成式引擎背後的模型理解文本依賴的是語義而非關鍵詞匹配,簡單堆詞容易被模型識別為低質內容。
- 效果最好的三種策略是”增加引言""增加統計資料""引用來源”,相對基線的提升幅度在 30%–40%(位置加權詞數)以及 15%–30%(主觀印象)之間。這三者的共同點是:都沒有要求創作者去”包裝”文風,而是讓內容本身更具可信度和資訊密度——補一條權威來源、補一句直接引語、補一個具體數字,投入成本很低,但回報相當可觀。
- 有點意外的是,單純改善文風的"提升流暢度"和"通俗化"也能帶來 15%–30% 的提升,說明生成式引擎不僅在乎"說了什麼",也在乎"說得好不好"。
- 反倒是把文風改得更”權威、有說服力”(Authoritative)這一項,提升並不顯著——論文認為這說明生成式引擎對純粹語氣上的說服力已經有一定的魯棒性,創作者更應該把精力放在內容本身的可信度上,而不是話術包裝。
進一步分析
不同領域適合不同策略
實戰中,SEO 從來不是”一招通吃”,GEO 同樣如此。論文按 GEO-bench 的標籤做了細分(對應原文 Table 3),發現:
|
策略 |
最適用領域(按效果排序) |
|---|---|
|
權威化 |
辯論類問題 > 歷史 > 科學 |
|
提升流暢度 |
商業 > 科學 > 健康 |
|
引用來源 |
陳述性問題 > 事實類 > 法律與政府 |
|
增加引言 |
人與社會 > 解釋類問題 > 歷史 |
|
增加統計資料 |
法律與政府 > 辯論 > 觀點類問題 |
這些規律相當符合直覺:辯論性問題天然歡迎更有說服力的論述方式;事實性問題需要引用作為”可驗證性”的背書;法律、政府這類強調資料和條文的領域,統計數字的說服力遠超抽象描述;而涉及個人敘事或歷史事件的內容,直接引語能增添真實感和厚度。這也呼應了論文反覆強調的觀點:創作者應該根據自己網站的內容領域,而不是盲目套用一種”萬能策略”。
當所有人都用上 GEO,誰受益最大?
一個自然的疑問是:如果未來所有創作者都開始用 GEO,會不會大家相互抵消、白忙一場?作者做了一個實驗——把同一條查詢下所有候選來源同時優化,觀察不同排名位置的網站各自獲得的相對提升(對應原文 Table 2):
|
方法 |
排名第1 |
排名第2 |
排名第3 |
排名第4 |
排名第5 |
|---|---|---|---|---|---|
|
權威化 |
-6.0% |
+4.1% |
-0.6% |
+12.6% |
+6.1% |
|
提升流暢度 |
-2.0% |
+5.2% |
+3.6% |
-4.4% |
+2.2% |
|
引用來源 |
-30.3% |
+2.5% |
+20.4% |
+15.5% |
+115.1% |
|
增加引言 |
-22.9% |
-7.0% |
+3.5% |
+25.1% |
+99.7% |
|
增加統計資料 |
-20.6% |
-3.9% |
+8.1% |
+10.0% |
+97.9% |
結果相當鮮明:排名越靠後的網站,從 GEO 中獲益越大;排名第一的網站反而可能因此被”拉下來”——比如”引用來源”策略讓原本排名第五的網站可見度暴漲 115%,而排名第一的網站平均下降了 30.3%。原因不難理解:傳統搜尋引擎排名很依賴反向連結數量、域名權重這類”馬太效應”明顯的因素,中小創作者很難和大機構拼這些資源積累;但生成式引擎是基於內容本身去理解和組織資訊,內容質量(引用、資料、引語)能直接轉化為曝光度,而不再受制於這些結構性壁壘。換句話說,GEO 有潛力成為縮小大網站和小創作者之間數字鴻溝的工具——這對個體經營者、獨立內容創作者是一個相當正面的訊號。
策略組合起來效果更好
現實中創作者不會只用一招,論文挑出表現最好的四種策略(引用來源、提升流暢度、增加統計資料、增加引言),兩兩組合後測試效果(對應原文 Figure 4 的熱力圖)。結果顯示,“提升流暢度”疊加”增加統計資料”是最佳組合,比單獨使用任何一種策略都高出 5.5% 以上。更有意思的是,“引用來源”單獨使用時效果排在四者中最末位(比增加引言低約 8%),但只要跟其他策略搭配使用,平均提升能達到 31.4%,是四種策略中”組合增益”最明顯的一個——這提示創作者:有些策略的價值要在組合裡才能完全釋放,不能光看單獨使用時的表現就否定它。
下表還原了這組兩兩組合的提升幅度(資料來自原文 Figure 4 的熱力圖,行列交叉處為兩種策略疊加後相對基線的平均提升):
|
|
流暢度 |
統計資料 |
引用來源 |
增加引言 |
行均值 |
|---|---|---|---|---|---|
|
流暢度 |
22.4% |
35.8% |
34.4% |
33.0% |
31.4% |
|
統計資料 |
35.8% |
27.0% |
30.3% |
35.4% |
32.1% |
|
引用來源 |
34.4% |
30.3% |
19.1% |
20.1% |
26.0% |
|
增加引言 |
33.0% |
35.4% |
20.1% |
30.3% |
29.7% |
對角線上的數值(比如”流暢度+流暢度”22.4%)代表同一策略重複使用兩次,作為對照基準;非對角線則是兩種不同策略疊加的效果。“行均值”一列正對應原文熱力圖最右側那一列——它清楚地顯示出”引用來源”單獨使用時排名最末,但只要和別的策略搭配,平均提升反而能衝到第三高。
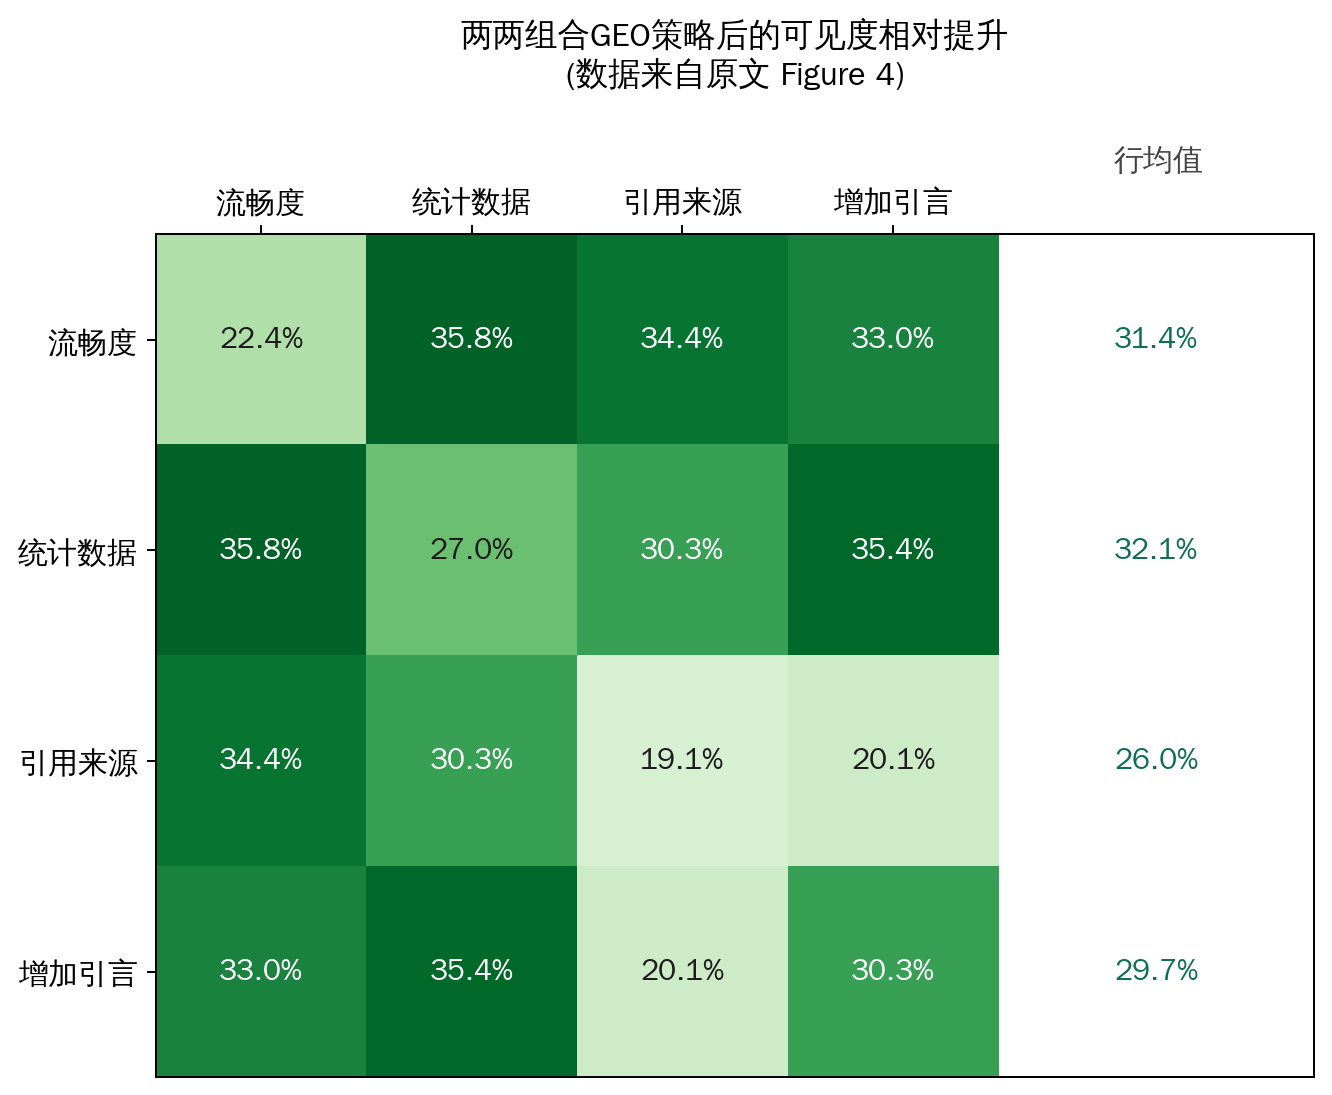
上圖根據原文 Figure 4 的資料重新繪製,顏色越深代表組合後的提升幅度越大。
真實案例長什麼樣
論文給了幾個直觀的優化案例(對應原文 Table 4),三個例子分別對應”引用來源""增加統計資料""權威化”三種策略,共同特點是:改動幅度都很小,但帶來的可見度提升非常可觀——比如僅僅給一句關於瑞士人均巧克力消費量的陳述補上一個調研機構的來源標註,可見度就提升了 132.4%;給一句關於機器人取代人力的論述補充一個具體的增長百分比,提升了 65.5%;把一句關於某支球隊戰績的平鋪直敘改寫得更斬釘截鐵、更強調既有成就,提升了 89.1%。這些例子說明,GEO 優化往往不需要創作新內容,只需要給已有內容”補一個來源、補一個數字、調整一下語氣的篤定程度”,門檻對普通創作者而言相當低。
走出實驗室:在 Perplexity.ai 上的真實驗證
為了證明這些發現不是”實驗室裡的自說自話”,作者把同樣的方法搬到了真實上線、擁有大量使用者的生成式引擎產品 Perplexity.ai 上做驗證(由於 Perplexity.ai 不支援直接指定來源 URL,實驗改為以檔案上傳的方式提供源文本,並限定回答只能基於上傳檔案生成),抽樣測試 200 條查詢(對應原文 Table 5):
|
方法 |
位置加權詞數 |
主觀印象 |
|---|---|---|
|
不優化(基線) |
24.1 |
24.7 |
|
關鍵詞堆疊 |
21.9 |
28.1 |
|
增加引言 |
29.1 |
32.1 |
|
增加統計資料 |
26.2 |
33.9 |
結果和實驗室設定高度一致:關鍵詞堆疊在位置加權詞數上依然是負向的(比基線還低約 10%),而增加引言、增加統計資料這類”內容增信”型策略依舊錶現突出,分別帶來約 22% 和 37% 的提升。這一結果有三層意義:一是再次確認了”為生成式引擎專門設計優化方法”的必要性;二是證明了這些方法不依賴某個特定的實驗性生成式引擎,具備跨產品的泛化能力;三是說明創作者完全可以直接照搬這些簡單易行的策略,在真實產品上獲得實際收益。
這項研究放在更大的脈絡裡
論文把自己的工作和三類前序研究做了區分:
- 帶證據的答案生成:像 WebGPT 這樣訓練模型在網頁環境中導航並生成有來源支撐的答案,以及其他基於搜尋結果生成回答的方法,GEO 的工作是在這些系統之上,提供一個統一的評測基準,並且——與近期一篇探討”如何用對抗性文本操縱 LLM 推薦以提升商品曝光”的工作不同——GEO 提出的是非對抗性的、面向任意網站內容的優化策略。
- 檢索增強生成:RAG、REALM 等工作主要解決語言模型”記不住知識”的問題,而生成式引擎的任務範圍更廣,既要生成答案又要全程標註來源,並且涵蓋查詢改寫、來源篩選等一整套子任務,不只是單純的檢索。
- 傳統 SEO:近 25 年的 SEO 研究分為站內優化(改善內容和體驗)和站外優化(建立反向連結、提升域名權威度)兩條線,但這套邏輯建立在”搜尋引擎做關鍵詞匹配”的假設上,在生成式引擎這種由生成模型驅動、不侷限於關鍵詞匹配的環境裡基本不適用,這正是 GEO 存在的意義。
結語與侷限
總結下來,這篇論文做了三件事:形式化定義了生成式引擎,提出了第一套面向生成式引擎的創作者優化框架 GEO(包括可見度指標體系和 9 種具體優化策略),以及構建並開源了評測基準 GEO-bench。核心發現是:補充引用、引語和統計資料這類”增信型”內容改動,能讓網站在生成式引擎回答中的可見度提升最高達 40%;不同領域適合不同策略;多種策略組合使用通常優於單獨使用;而且排名靠後的小網站從 GEO 中獲益尤其明顯,這對個體創作者和中小網站是一個積極訊號。
作者也坦誠地列出了幾點侷限:首先,生成式引擎本身在快速演變,正如 SEO 歷史上經歷過的那樣,GEO 方法很可能也需要隨之持續迭代;其次,儘管 GEO-bench 力求貼近真實查詢分佈,但查詢的性質會隨時間變化,基準需要持續更新;第三,由於搜尋引擎排序演算法本身是黑箱,論文沒有評估 GEO 修改是否會反過來影響傳統搜尋排名——作者的判斷是,GEO 所做的改動主要集中在文本內容層面,並不觸及域名、反向連結等傳統排名因子,因此影響應該有限;最後,隨著模型上下文長度的提升,未來生成式引擎能夠”消化”的來源數量會更多,這也可能進一步降低”搜尋排名位置”本身的重要性。整體來看,這篇論文更像是給一個全新領域打地基——它提出的框架、指標和基準,是為了讓後續研究者能在一個共同的標準上繼續往前推進。