Wie Inhalte in Antworten einfließen, wenn KI keine Linklisten mehr zeigt
KI zeigt keine Linkliste mehr, sondern entscheidet innerhalb der Antwort, wer sichtbar wird. AgenticGEO passt Inhalte an den jeweiligen Kontext an, statt eine universelle Vorlage anzuwenden. Es sucht die Belege, Strukturen und Formulierungen, die KI am ehesten übernimmt.
Themen
4Zusammenfassung
KI zeigt keine Linkliste mehr, sondern entscheidet innerhalb der Antwort, wer sichtbar wird. AgenticGEO passt Inhalte an den jeweiligen Kontext an, statt eine universelle Vorlage anzuwenden. Es sucht die Belege, Strukturen und Formulierungen, die KI am ehesten übernimmt.
Wie Inhalte in Antworten einfließen, wenn KI keine Linklisten mehr zeigt
Ein vertrautes Beispiel: Früher suchten Sie nach „Welcher Luftreiniger bietet ein gutes Preis-Leistungs-Verhältnis?“, sahen eine Reihe von Titeln und Links und verglichen die Seiten selbst. Heute fragen Sie einen KI-Assistenten oder Googles AI Overview und erhalten einen Absatz: „Mehreren Tests zufolge überzeugt Marke XX bei CADR und Geräuschkontrolle [1], während bei Marke YY die Filterwechselkosten niedriger sind [2] …“ Die KI formuliert die Antwort selbst. Statt zehn Links sehen Sie einen Text, der Informationen mehrerer Websites mit Quellenverweisen verbindet.
Für Nutzer ist das bequem. Für Menschen, die Tests, Produktbeschreibungen und Wissensartikel verfassen, ändern sich jedoch die Spielregeln. Früher ging es darum, auf welcher Suchergebnisseite und Position man erschien. Heute zählt, ob die KI eigene Inhalte übernimmt, den Namen nennt und ihnen genügend Raum in der Antwort gibt. Die Studie bezeichnet dieses neue Optimierungsfeld als Generative Engine Optimization, kurz GEO. „AgenticGEO: A Self-Evolving Agentic System for Generative Engine Optimization“ von Jiaqi Yuan und weiteren Forschern der Beihang University erschien im März 2026 auf arXiv. Vereinfacht gesagt entwickeln sie einen selbstlernenden Content-Optimierungsassistenten, der Inhalte so umformuliert, dass KI sie eher übernimmt und zitiert. Er wird mit der Nutzung besser, ohne jede Überarbeitung ständig bei einem echten KI-System testen zu müssen.
Im Folgenden erläutern wir die Studie in verständlicher Sprache und zeigen ihre wichtigsten Abbildungen und Tabellen.
------
1. Zwei Denkweisen: Rankings erzielen vs. in Antworten übernommen werden
Klassisches SEO fragt, wie eine Seite mithilfe von Keywords, Backlinks und anderen Signalen auf die erste Ergebnisseite gelangt. Ein generatives System zeigt die eigene Seite aber nicht einfach im Ranking an. Es zerlegt Inhalte mehrerer Quellen und setzt daraus eine Antwort zusammen. Das Ranking ist deshalb nicht mehr das Endziel. Die Studie unterscheidet zwei GEO-Ziele:
- Sichtbarkeit: ob Ihre Inhalte in der generierten Antwort enthalten sind;
- Quellenzuordnung: ob die Antwort Ihre Quelle nennt und einen Quellenverweis setzt.
Davon hängt ab, ob Nutzer zu Ihrer Website zurückkehren und erkennen, dass die Information von Ihnen stammt. Deshalb verbindet die Studie GEO mit der Nachhaltigkeit des Web-Ökosystems: Wie KI-Antworten Aufmerksamkeit verteilen, bestimmt zunehmend auch die Verteilung von Traffic und Sichtbarkeit.
2. Warum es keine universelle Optimierungsvorlage gibt
Die Studie beginnt mit einem aufschlussreichen Experiment. Sie wendet 9 verbreitete Methoden – etwa Keyword-Stuffing, fachlichere Sprache, maßgebliche Quellenangaben, Zitate und Statistiken – auf GEO-Bench-Inhalte an. Das Ergebnis: Keine einzelne Methode funktioniert für alle Inhalte, und bei nahezu der Hälfte der Inhalte hilft keine der 9 Methoden.
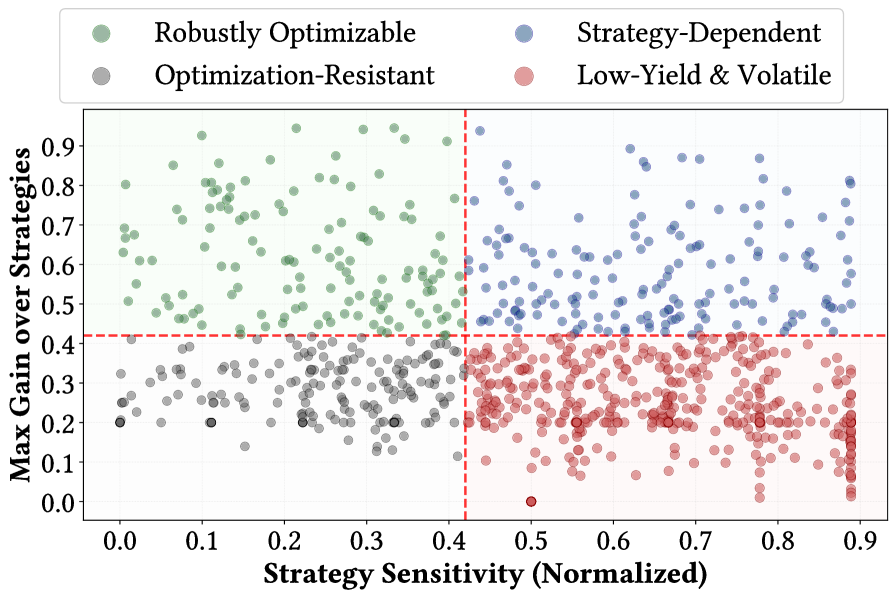
In Abbildung 1 zeigt die horizontale Achse die Strategiesensitivität: Hohe Werte bedeuten, dass nur wenige Strategien wirken und ein Wechsel den Vorteil aufheben kann. Die vertikale Achse zeigt den maximalen Gewinn durch die beste Strategie. Die Studie unterscheidet vier Gruppen: robust optimierbare Inhalte, die mit vielen Ansätzen gewinnen (oben links); strategieabhängige Inhalte, die den passenden Ansatz benötigen (oben rechts); optimierungsresistente Inhalte mit geringem Nutzen (unten links); und stark schwankende Ergebnisse mit hohem Zufallsanteil (unten rechts).
Die Schlussfolgerung liegt nahe: Alle Inhalte nach derselben Formel umzuschreiben, ist der falsche Ausgangspunkt. Denken Sie an Produktempfehlungen für den Haushalt: Ein Test eines intelligenten Toilettensitzes und ein Test von Säuglingsnahrung benötigen sehr unterschiedliche Schwerpunkte. Beim einen zählen genaue Reinigungsparameter und Sicherheitsnachweise, beim anderen maßgebliche Belege und Erfahrungen echter Familien. Eine gemeinsame Vorlage wird voraussichtlich keinem gerecht.
3. Wie AgenticGEO vorgeht
Die Grundidee lässt sich in einem Satz ausdrücken: Statt eines starren Ansatzes wird eine ganze Strategiebibliothek gepflegt, aus der ein kostengünstiger simulierter Bewerter die passenden Optionen auswählt.
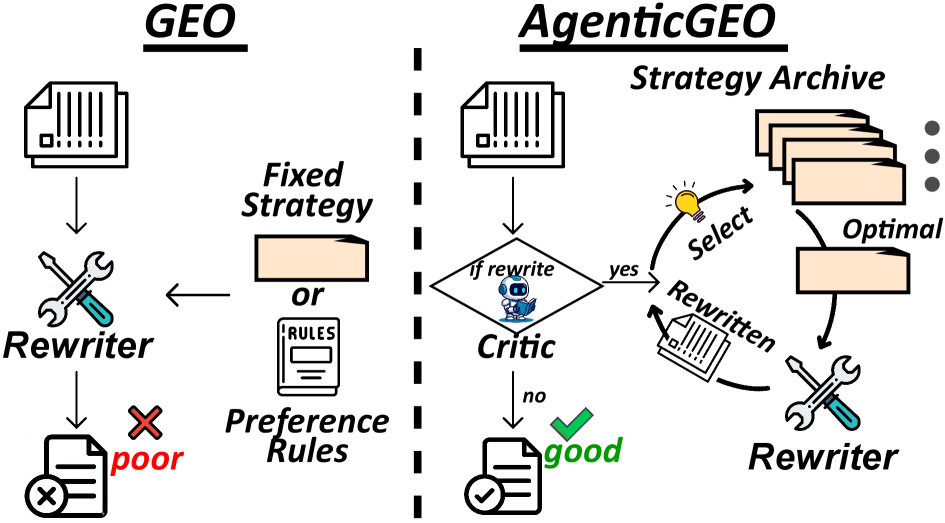
Wie Abbildung 2 zeigt, arbeiten klassische GEO-Methoden mit festen Umschreibungsformeln. AgenticGEO pflegt dagegen ein wachsendes Strategiearchiv und ein Bewertungsmodell, das Strategien für jeden Inhalt dynamisch auswählt und anpasst.
Das System arbeitet in drei Phasen:
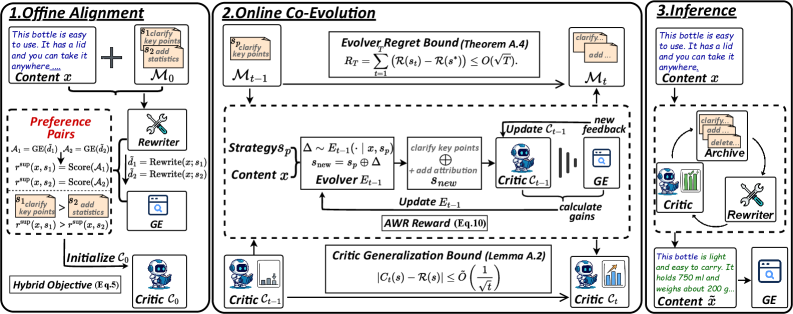
Phase 1: Offline-Vorbereitung. Zunächst wendet das System 9 grundlegende Strategien – etwa die zuvor erwähnte Keyword-Anhäufung, Quellenangaben und Statistiken – auf die Trainingsdaten an. Es erfasst, wie viel zusätzliche Sichtbarkeit jede Strategie tatsächlich erzielt, und trainiert mit diesen Ergebnissen ein schlankes Bewertungsmodell, das die Studie „Critic“ nennt. Vereinfacht gesagt ist der Critic ein kostengünstiger Ersatzprüfer: Anhand eines Inhalts und einer möglichen Strategie schätzt er schnell ab, wie stark diese Überarbeitung den Wert verbessern könnte. Eine echte Anfrage an die KI-Engine, die Zeit und Geld kostet, ist dafür nicht nötig.
Phase 2: Online-Koevolution. Dies ist der interessanteste Teil der Studie. Das System führt ein sogenanntes MAP-Elites-Archiv. Man kann es sich als Schrank mit getrennten Fächern vorstellen, statt als eine einzige Rangliste der insgesamt besten Strategien. Es ordnet die Strategien nach fünf Dimensionen ein (Tabelle 1 der Studie):
|
Aspekt |
Bedeutung und Beispiele |
|---|---|
|
Instruction (Anweisung) |
Legt Ziel und Umfang der Überarbeitung fest, etwa die Zielgruppe, besonders hervorzuhebende Fakten und die einzunehmende Expertenrolle |
|
Constraints (Vorgaben) |
Setzt verbindliche Grenzen, etwa zur Textlänge, zur Prüfung von Quellenangaben, zur Vermeidung erfundener Aussagen und zur sachlichen Konsistenz |
|
Reasoning (Schlussfolgerung) |
Ergänzt logische Schritte wie den Umgang mit Widersprüchen, Selbstprüfung, schrittweise Planung und die Überprüfung von Schlussfolgerungen |
|
Format |
Steuert die Darstellung, etwa die Verwendung von Listen, Codeblöcken, einer festen Ausgabevorlage oder einer einleitenden Zusammenfassung |
|
Tone (Tonalität) |
Passt den Schreibstil an, etwa wie bestimmt oder fachlich der Text klingt und ob die Wortwahl einfach oder formell sein soll |
Ein Beispiel aus dem Wohnbereich: Bei einem Saugroboter-Test könnte eine Kombination lauten: „Anweisung = Reinigungsabdeckung hervorheben + Vorgabe = Herkunft der Messdaten angeben + Tonalität = fachlich und souverän“. Eine andere könnte lauten: „Anweisung = Preis-Leistungs-Verhältnis vergleichen + Format = Optionen nach Preisklasse auflisten + Tonalität = zugänglich, wie im Gespräch unter Freunden“. Im Archiv liegen diese Kombinationen in getrennten Fächern; jede konkurriert nur mit Strategien ähnlichen Stils um einen Platz. So läuft nicht alles auf einen einzigen fachlich-souveränen Stil hinaus. Das System bewahrt unterschiedliche Varianten auf und nutzt sie, wenn sie zum jeweiligen Inhalt passen.
Eine neue Strategie muss zwei Prüfungen bestehen, um in ein Fach aufgenommen zu werden: bessere Wirkung als die Strategie, die bereits im Fach liegt (Nutzenprüfung), eine klare Unterscheidung von vorhandenen Strategien (Neuheitsprüfung anhand der n-Gramm-Ähnlichkeit). Auch wenn eine neue Strategie derzeit nicht den höchsten Wert erreicht, kann sie als spätere Alternative erhalten bleiben, sofern sie sich ausreichend unterscheidet.
Die Koevolutionsschleife funktioniert ungefähr so (Algorithmus 1 der Studie, hier in vier verständliche Schritte gefasst):
- Generieren: Mehrere Elternstrategien aus dem Archiv auswählen. Einige verändert ein KI-basierter Evolver mit neuronalen Verfahren; andere erhalten vorgegebene, regelbasierte Änderungen, etwa den Wechsel von Absätzen zu Listen oder von einer zurückhaltenden zu einer bestimmten Tonalität;
- Auswählen: Der Critic bewertet alle Kandidaten und wählt die vielversprechendsten aus. Hinzu kommen einige zufällige Kandidaten, damit das System nicht nur sich selbst wiederholt und in einer Informationsblase stecken bleibt;
- Validieren: Die ausgewählten Strategien tatsächlich an der KI-Engine erproben, um reales Feedback zu erhalten. Für nicht geprüfte Strategien dienen vorerst die Schätzwerte des Critic;
- Lernen: Mit den realen und geschätzten Rückmeldungen sowohl den Evolver aktualisieren, damit er wirksamere Überarbeitungsschritte lernt, als auch den Critic, damit seine Bewertungen genauer werden.
Ein besonders durchdachtes Detail heißt „Sibling-Aware AWR (geschwisterbezogene Vorteilsbewertung)“. Manche Inhalte sind von sich aus schwerer zu verbessern: Ein bereits sehr fundierter Text bietet beispielsweise wenig Spielraum. Wer nur auf den Punktezuwachs schaut, kann deshalb die tatsächliche Wirkung eines Überarbeitungsschritts falsch einschätzen. Das System vergleicht Varianten derselben Elternstrategie miteinander, statt sie an sämtlichen Strategien zu messen. So lässt sich besser unterscheiden, ob der Überarbeitungsschritt selbst wirksam war oder ob sich der Inhalt einfach besonders leicht verbessern ließ.
Phase 3: Mehrere Überarbeitungsrunden bei der Inferenz. Nach dem Training übernimmt der Critic bei der Optimierung neuer Inhalte die Rolle eines schnellen Planers. In jedem Schritt wählt er aus dem Archiv die Strategie mit dem aktuell höchsten geschätzten Nutzen und überarbeitet damit den Text. Anschließend prüft er, ob sich das Ergebnis weiter verbessert hat. Gibt es keine bessere Strategie mehr oder wurden bereits drei Runden durchgeführt – die Obergrenze im Experiment –, endet der Vorgang. Eine Sperrliste verhindert, dass eine Strategie erneut verwendet wird. So muss jede Runde etwas Neues beitragen, statt denselben Ansatz immer wieder anzuwenden.
4. Wie zuverlässig ist das Verfahren, und gibt es mathematische Garantien?
Die Studie enthält eine theoretische Analyse unter üblichen Annahmen, darunter ein linear wachsender Replay-Puffer und die Lipschitz-Stetigkeit des Critic. Unter diesen Bedingungen beträgt der kumulative Regret des Koevolutionsverfahrens aus Critic und Evolver – also der aufsummierte Abstand zu einer theoretisch optimalen Strategie – $\mathcal{O}(\sqrt{T})$. Mit steigender Zahl T an Durchläufen wird der durchschnittliche Abstand zur optimalen Strategie somit immer kleiner und nähert sich null. Einfach gesagt: Das System verlässt sich nicht bloß auf Zufall: Je länger es läuft, desto näher kommt seine Strategieauswahl theoretisch an das Optimum. Der Anhang enthält den vollständigen Beweis in drei Schritten: eine Konzentrationsungleichung für die Größe des Replay-Puffers, eine Schranke für den Generalisierungsfehler des Critic und eine Regret-Schranke für das Online-Lernen des Evolver. Einzelheiten stehen in Anhang A.3 der Originalstudie.
5. Wie gut funktioniert es tatsächlich?
Für Training und Evaluation innerhalb der Trainingsdomäne nutzt die Studie GEO-Bench, überwiegend längere Inhalte aus Google-Suchergebnissen. Zusätzlich testet sie auf zuvor ungesehenen Domänen: MS MARCO mit kurzen Texten aus Bing-Suchprotokollen und einem selbst erstellten E-Commerce-Datensatz aus Amazon-Produktbeschreibungen und Rezensionen. Die nachgelagerte Antwortgenerierung übernehmen zwei Modelle unterschiedlicher Architektur und Größe: Qwen2.5-32B-Instruct und Llama-3.3-70B-Instruct.
Ergebnisse innerhalb der Trainingsdomäne (Tabelle 2):
|
Methode |
Qwen2.5-32B gesamt |
Llama3.3-70B gesamt |
|---|---|---|
|
Ohne Optimierung |
20.21 |
19.20 |
|
Keyword-Anhäufung |
20.69 |
20.02 |
|
Autoritative Tonalität |
20.60 |
19.47 |
|
Quellenangaben ergänzen |
22.53 |
21.98 |
|
Zitate bekannter Persönlichkeiten ergänzen |
23.76 |
21.57 |
|
AutoGEO (die zuvor stärkste Vergleichsmethode) |
23.71 |
22.78 |
|
AgenticGEO (die Methode dieser Studie) |
25.48 |
24.52 |
|
Verbesserung gegenüber der stärksten Vergleichsmethode |
26.08% |
27.71% |
Grobe Methoden wie Keyword-Anhäufung oder ein autoritativer Ton bringen nur begrenzte Verbesserungen; manche schneiden sogar schlechter ab als gar keine Optimierung. Der Einsatz ungewöhnlicherer Wörter senkt den Wert beispielsweise bei beiden Engines auf 17–18 und schadet damit eher. AgenticGEO erzielt bei beiden Engines trotz unterschiedlicher Architektur und Größe die besten Ergebnisse. Das deutet darauf hin, dass das System eine allgemeinere Optimierungslogik lernt, statt nur die besonderen Vorlieben einer einzelnen Engine.
Was passiert in einer neuen Domäne? (Tabelle 3, domänenübergreifender Test):
|
|
MS MARCO gesamt (Qwen) |
E-Commerce gesamt (Qwen) |
|---|---|---|
|
AutoGEO |
30.67 |
21.18 |
|
AgenticGEO |
34.10 |
26.58 |
|
Verbesserung |
Etwa 70 % |
Etwa 47,6 % |
Diese Zahlen sind noch aussagekräftiger. In der Trainingsdomäne liegt AgenticGEO um mehr als 20 % vorn; bei völlig unbekannten Inhaltstypen wächst der Vorsprung auf fast 50–70 %, insbesondere bei E-Commerce-Produktbeschreibungen mit vielen Entitätsbezeichnungen. Das spricht für eine übertragbare, inhaltsabhängige Optimierungslogik statt für auswendig gelernte Überarbeitungsmuster. Auf den Wohn- und Alltagsbereich übertragen: Es ist wie ein Autor, der Saugroboter-Testberichte schreiben gelernt hat und anschließend auch Kinderwagen kompetent testen kann, statt lediglich eine Saugroboter-Vorlage wiederzuverwenden.
Der Beitrag der einzelnen Komponenten (Abbildung 4):
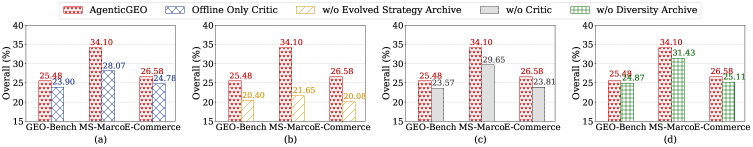
Die Studie untersucht vier Varianten: (a) nur der offline trainierte Critic, ohne Online-Evolution; (b) vollständiger Verzicht auf das Strategiearchiv; (c) zufällige Überarbeitung statt Critic-gesteuerter Planung; und (d) Auswahl der Archivstrategien ausschließlich nach Bewertung, ohne Berücksichtigung ihrer Vielfalt. Das Ergebnis: Das Entfernen des Archivs verursacht den stärksten Leistungsabfall. Das zeigt, dass der langfristige Aufbau vielfältiger Strategien die wesentliche treibende Kraft ist. Auch ein ausschließlich offline trainierter Critic ist deutlich schwächer, was die Bedeutung einer laufenden Online-Kalibrierung unterstreicht. Zufällige Planung und der Verzicht auf Vielfalt verschlechtern die Ergebnisse ebenfalls. Vielfalt ist also tatsächlich nützlich und kein bloßes Schmuckelement.
Auswahl der Hyperparameter (Abbildung 5):
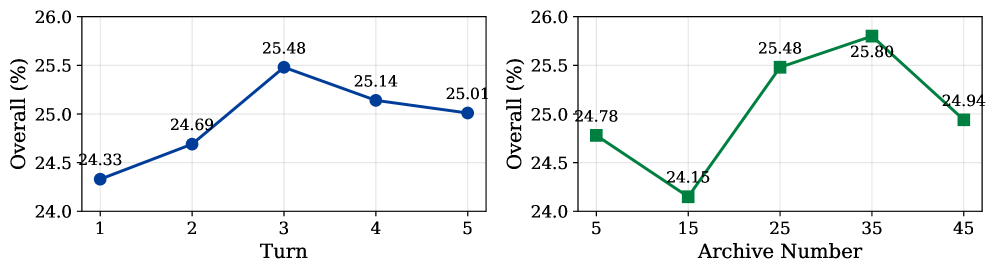
In den Experimenten erzielt die mehrstufige Überarbeitung die besten Ergebnisse nach 3 Runden, mit einem Gesamtwert von 25,48. Weitere Runden bringen kaum zusätzlichen Nutzen; eine kurze, gezielte Planung reicht offenbar aus. Am besten funktioniert das Archiv mit 25 bis 35 Strategien, mit dem Höchstwert bei 35. Kleinere und größere Archive schneiden schlechter ab: Ein zu kleines Archiv erkundet zu wenig, ein zu großes kann die Auswahl ineffizienter machen. Dies ist der klassische Zielkonflikt zwischen Exploration und Exploitation.
Wie genau ist der offline trainierte Critic? (Tabelle 4):
|
Datensatz |
NDCG@1 |
NDCG@3 |
NDCG@5 |
|---|---|---|---|
|
GEO-Bench |
84.01 |
93.89 |
94.98 |
|
MS-Marco |
77.73 |
81.39 |
82.82 |
|
E-Commerce |
68.47 |
73.77 |
78.46 |
NDCG ist eine gängige Kennzahl für die Qualität von Rangfolgen. Je höher der Wert, desto besser stimmt die vom Critic prognostizierte Reihenfolge der Strategien mit der tatsächlichen überein. Innerhalb der Trainingsdomäne liegt NDCG@5 bei fast 95 %; der Critic bildet die Präferenzen der echten Engine damit nahezu exakt ab. In völlig unbekannten Domänen sinkt die Qualität etwas, bleibt aber bei etwa 70–80 %. Das spricht für eine übertragbare Beurteilungslogik dieses Ersatzprüfers statt für bloßes Auswendiglernen der Trainingsdaten.
Kosteneinsparungen (Abbildung 6):
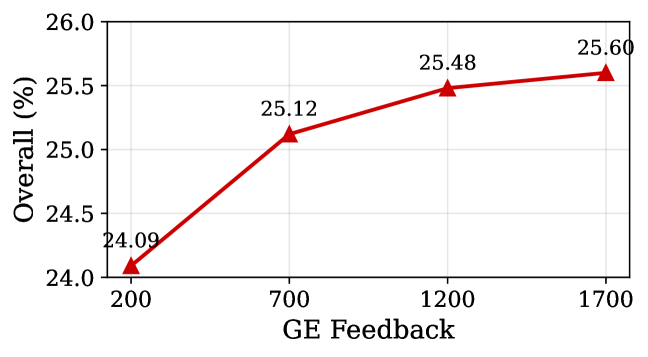
Diese Abbildung beantwortet eine praktische Frage: Echte Anfragen an die KI-Engine kosten Zeit und API-Aufrufe. Kommt das System auch mit weniger Anfragen aus? Die Antwort: Mit nur 700 echten Rückmeldungen – 41,2 % der Gesamtzahl – erreicht das System 25,12 Punkte und damit 98,1 % des Werts von 25,60 bei vollständigem Feedback. Der kostengünstige Critic spart also fast 60 % der Kosten echter Anfragen, bei nahezu unveränderter Leistung. Das ist vergleichbar mit einem Assistenten, der zunächst die Kandidaten vorsortiert: Nur die aussichtsreichsten werden anschließend tatsächlich geprüft, statt jeden einzelnen zur Prüfung zu schicken.
Bleibt die ursprüngliche Bedeutung nach der Überarbeitung erhalten? (Abbildung 7):
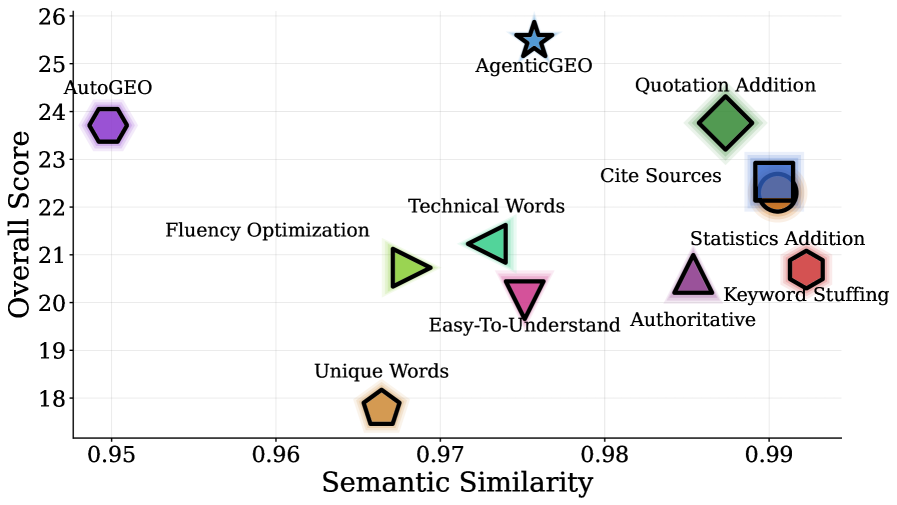
Dies ist eine wichtige Prüfung: Werden höhere Werte dadurch erkauft, dass der Inhalt kaum wiederzuerkennen ist? Die Studie misst die semantische Ähnlichkeit vor und nach der Überarbeitung mit BERTScore. Die meisten herkömmlichen heuristischen Verfahren erhalten die Bedeutung gut, verbessern die Werte aber nur begrenzt. AutoGEO erzielt stärkere Zuwächse, weist jedoch eine deutlich geringere semantische Ähnlichkeit auf. Ein Teil des Erfolgs scheint also auf sehr weitgehenden Änderungen und thematischen Abweichungen zu beruhen. Dagegen erzielt AgenticGEO die höchsten Werte und bewahrt zugleich eine vergleichsweise hohe semantische Ähnlichkeit. Das spricht für gezielte, präzise Anpassungen statt für eine umfassende Neufassung. Für Content-Autoren ist das entscheidend: Ein paar zusätzliche KI-Zitate sollten nicht dazu führen, dass die ursprüngliche Aussage verloren geht.
6. Drei konkrete Beispiele für die Überarbeitung
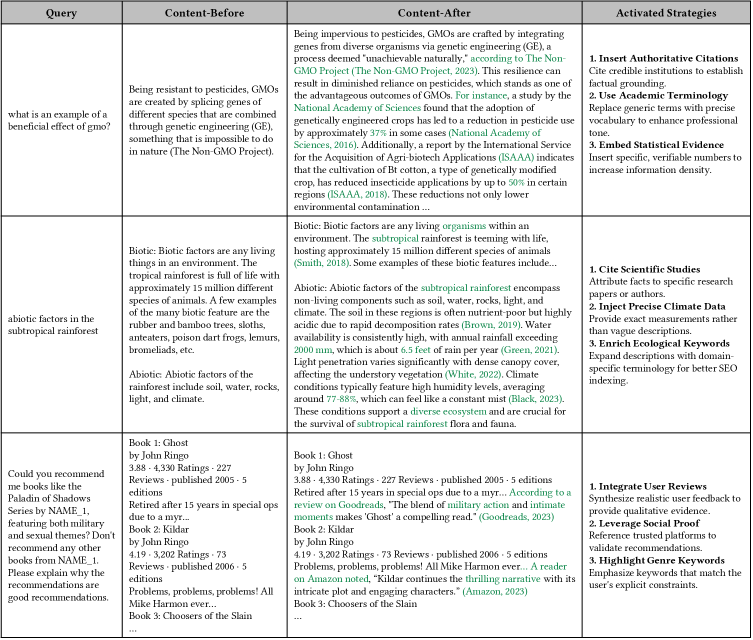
Der Anhang der Studie zeigt drei konkrete Optimierungsverläufe aus unterschiedlichen Bereichen (Abbildung 8):
- Inhalte zu GVO (gentechnisch veränderten Nutzpflanzen): Das System ergänzt Quellenangaben maßgeblicher Institutionen und konkrete Statistiken, um die sachliche Grundlage zu stärken;
- Inhalte zu subtropischen Regenwäldern: Das System ergänzt genaue Klimamesswerte und Fachbegriffe, um den Inhalt fundierter und fachlich aussagekräftiger zu machen;
- Inhalte zu Buchempfehlungen: Das System wählt einen anderen Weg und bündelt echte Rezensionen mehrerer Plattformen. Durch soziale Bestätigung – also die Zustimmung vieler Menschen – gewinnt der Text an Überzeugungskraft.
Zusammen verdeutlichen diese drei Beispiele: Dasselbe System wählt für unterschiedliche Arten von Inhalten völlig verschiedene Vorgehensweisen. Bei sachbezogenen Inhalten helfen zusätzliche Belege und Daten, bei sozialen Empfehlungen die Erfahrungen und Urteile anderer. Das bestätigt die Ausgangsbeobachtung der Studie: Eine universelle Vorlage gibt es nicht. Entscheidend ist, die Vorgehensweise an den jeweiligen Inhalt anzupassen.
Ein alltagsnäheres Beispiel: Bei einem Vergleich zwischen einem Xiaomi-Luftreiniger und dem Gerät einer anderen Marke würde das System vermutlich konkrete CADR-Werte und Geräuschpegel sowie Zertifizierungsquellen anerkannter Prüfstellen ergänzen. Bei einer Liste empfehlenswerter Kinderbilderbücher für dieses Jahr würde es eher echte positive Leserrezensionen großer Plattformen und Signale sozialer Bestätigung wie die Zahl der Neuauflagen hinzufügen, statt Fachbegriffe hineinzuzwängen. Eltern möchten beim Bilderbuchkauf meist wissen, wie das Buch bei anderen ankommt, und keine technischen Daten studieren.
7. Abschließende Gedanken
Im Kern behandelt die Studie eine praktische Frage: Wie sollten sich Content-Autoren anpassen, wenn Suchmaschinen nicht mehr nur Links anzeigen, sondern Antworten formulieren? Ihr Ansatz ist pragmatisch. Sie erklärt nicht, wie man KI-Schwachstellen ausnutzt oder sich durch Tricks Quellenverweise verschafft. Stattdessen betont sie immer wieder die inhaltliche Qualität und gezielte, zum Text passende Verbesserungen. Die ursprüngliche Bedeutung soll erhalten bleiben; Sichtbarkeit soll nicht durch verfälschte Informationen entstehen. Die Studie endet mit dieser Richtung: Qualität und Vielfalt zu belohnen statt opportunistischer Vorlagennutzung kann ein für Content-Autoren und KI-Engines gleichermaßen vorteilhaftes Ökosystem schaffen, statt Autoren ständig über die Vorlieben der KI rätseln zu lassen, während wechselnde Präferenzen der Engines ihre Arbeit immer schwieriger machen.