AI がリンクを並べなくなったとき、コンテンツはどうすれば回答に採用されるのか
AI はリンクの一覧を表示するのではなく、回答の中で誰を見せるかを決めます。AgenticGEO の価値は、万能テンプレートを当てはめず、状況に応じてコンテンツを適応的に最適化し、AI に採用される可能性が最も高い証拠、構成、表現を見つける点にあります。
トピック
4要旨
AI はリンクの一覧を表示するのではなく、回答の中で誰を見せるかを決めます。AgenticGEO の価値は、万能テンプレートを当てはめず、状況に応じてコンテンツを適応的に最適化し、AI に採用される可能性が最も高い証拠、構成、表現を見つける点にあります。
AI がリンクを並べなくなったとき、コンテンツはどうすれば回答に採用されるのか
まず、ある場面を考えてみましょう。以前なら「どの空気清浄機がコスパに優れているか」を知りたいとき、検索エンジンを開き、並んだタイトルとリンクを一つずつクリックして比較していました。今は違います。AI アシスタントや Google の AI Overview に聞けば、「複数のレビューを総合すると、XX ブランドは CADR と騒音制御で優れた性能を示しています [1]。一方、YY ブランドはフィルター交換の費用を抑えられます [2]……」と、その場で文章を書いてくれます。答えは AI 自身が「書いた」もので、目にするのは十個のリンクではなく、複数のサイトの情報を統合し、引用番号を付けた一つの文章です。
ユーザーには便利になったように見えますが、レビュー、商品紹介、科学解説などを書くコンテンツ制作者にとっては、ルールが根本から変わりました。以前競っていたのは「検索結果の何ページ目の何位か」でした。今競うのは「AI の回答で自分が取り上げられているか、名前が出ているか、自分の文章がどの程度引用されているか」です。論文では、この新しい最適化の領域を「生成エンジン最適化」(Generative Engine Optimization、略称 GEO)と呼んでいます。今回取り上げる論文は「AgenticGEO: A Self-Evolving Agentic System for Generative Engine Optimization」。北京航空航天大学の Jiaqi Yuan らによるもので、2026 年 3 月に arXiv で公開されました。取り組みを簡単に言えば、AI に採用・引用されやすくなるようコンテンツを書き換える、自己進化型の「コンテンツ最適化アシスタント」をつくることです。このアシスタントは使うほど賢くなり、毎日のように本物の AI エンジンへ「この書き方でよいですか」と問い合わせる必要がありません。
以下では、できるだけわかりやすい言葉で論文を最初から順に読み解き、主要な図表も紹介します。
------
一、順位重視の発想と採用重視の発想
従来の SEO(検索エンジン最適化)が重視するのは、「自分のページをどうすれば検索結果の最初のページに表示できるか」であり、キーワードや被リンクなどのシグナルに頼ります。一方、生成エンジンはページを並べて見せるのではなく、複数の情報源を「かみ砕き」、一つの回答に再構成します。この仕組みでは、順位はもはや終着点ではありません。論文は GEO の目標を二つに分けています。
- 可視性(Visibility):AI が生成した回答に、自分のコンテンツが含まれているか。
- 出典の明示(Attribution):出典が明記され、自分の情報に引用マークが付いているか。
この二つは、ユーザーが自分のサイトへ戻ってくるか、その情報を自分が書いたものだと認識するかを直接左右します。論文が GEO を「ウェブ生態系全体の持続可能性に関わる」と述べるのも、このためです。今後、AI の回答が注意をどう配分するかは、ある意味でアクセスと露出をどう配分するかに等しいのです。
二、「万能の最適化テンプレート」が存在しない理由
論文の冒頭では、なかなか厳しい結果を示す実験が行われています。キーワードの詰め込み、専門用語の使用、権威ある出典の追加、著名人の言葉の引用、統計データの追加など、一般的な 9 種類の最適化手法を GEO-Bench データセットのコンテンツに適用し、どの手法が有効かを調べました。その結果、あらゆるコンテンツに通用する手法は一つもありませんでした。さらに、半数近くのコンテンツでは、この 9 種類の手法のどれを使っても改善できませんでした。
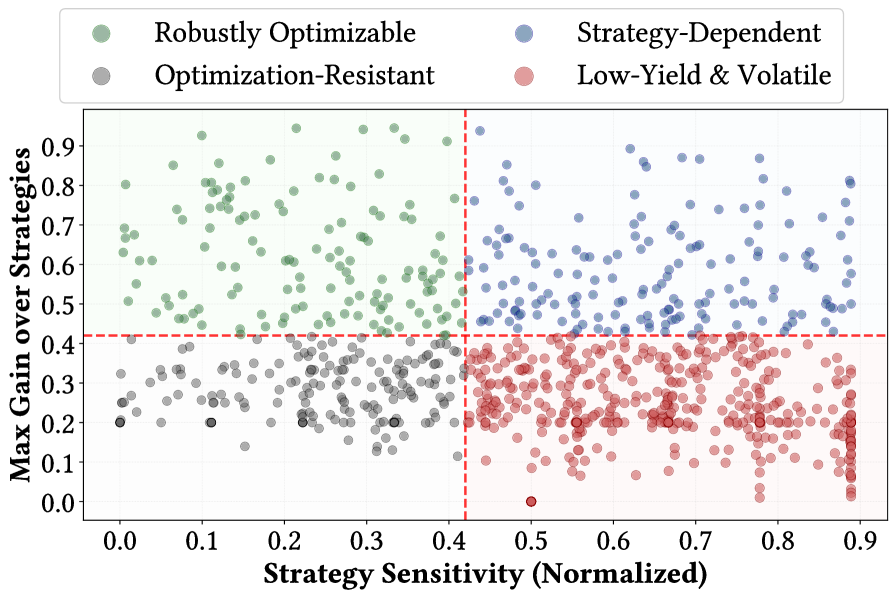
上の図(論文の Figure 1)の横軸は「戦略感度」です。値が高いほど、少数の戦略しか有効でなく、戦略を変えると効果が失われます。縦軸は「最良の戦略による最大の改善幅」です。論文はサンプルを四つに分類しています。「どの方法でも改善する」コンテンツ(左上:安定して最適化可能)、「正しい戦略を選ばなければ効果がない」コンテンツ(右上:戦略依存型)、「どの方法でもあまり改善しない」コンテンツ(左下:最適化への抵抗が強い)、そして「結果の上下が大きく、偶然に左右される」コンテンツ(右下)です。
ここから、わかりやすい結論が導かれます。すべてのコンテンツを同じ型で書き換えるという出発点自体が間違っています。 暮らしに役立つ商品の紹介を例にすると、温水洗浄便座と乳児用粉ミルクのレビューでは、強調すべき点がまったく違います。前者は正確な洗浄性能の数値と安全認証、後者は権威ある機関による裏づけと実際の家庭からの声が重要です。同じテンプレートを使えば、どちらもうまくいかない可能性が高いでしょう。
三、AgenticGEO はどう取り組むのか
論文が提案する解決策の核心は、一文で言えます。一つの戦略に固執せず、「戦略の倉庫」を育て、低コストで使いやすい「模擬採点官」に選択を手伝わせる。
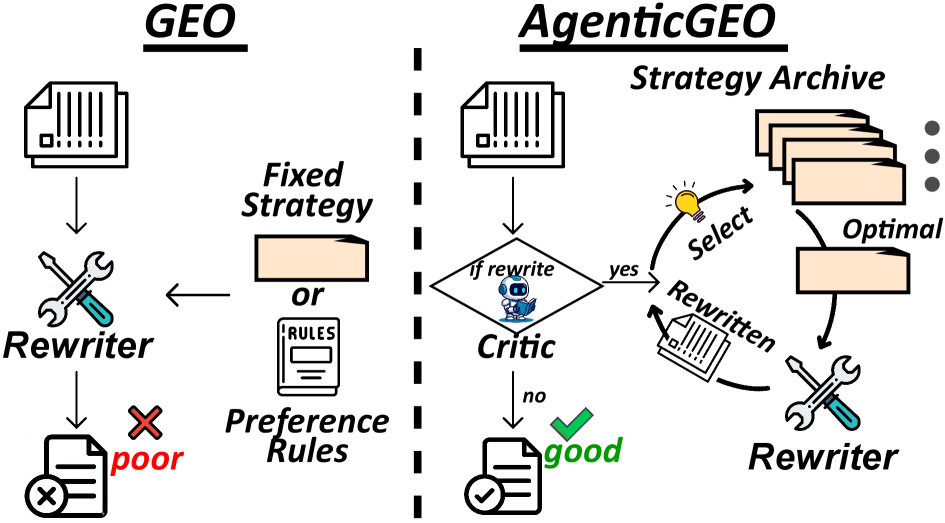
上の図(Figure 2)が比較しているように、従来の GEO は固定された書き換えの型を使います。一方、AgenticGEO は進化し続ける戦略アーカイブと採点モデルを組み合わせ、個々のコンテンツに合わせて戦略を動的に選び、書き換えます。
システム全体は三つの段階で動作します。
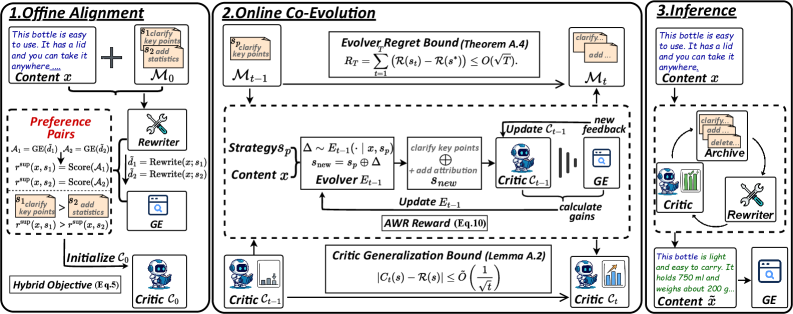
第一段階:オフラインでの準備。 まず、前述のキーワードの詰め込み、出典の引用、統計データの追加など、9 種類の基本戦略を学習データに適用します。各戦略が「可視性」をどれだけ高めたかを記録し、その実測データを使って軽量な採点モデルを学習させます。論文ではこれを「Critic」(評価者)と呼びます。簡単に言えば、Critic は低コストの代理採点官です。コンテンツと候補となる戦略を渡すと、「こう書き換えれば、どのくらいスコアが上がりそうか」を素早く予測します。費用も時間もかかる本物の AI エンジンへの問い合わせを、毎回行わずに済みます。
第二段階:オンラインでの共進化。 ここが論文で最も興味深い部分です。システムは「MAP-Elites アーカイブ」を維持します。「総合ベストランキング」ではなく、種類別に整理された収納棚だと考えるとわかりやすいでしょう。戦略を五つの軸で分類します(論文の Table 1)。
|
比較項目 |
意味と例 |
|---|---|
|
Instruction(指示) |
対象読者、強調する主要な事実、想定する専門家の役割など、書き換えの目的と範囲を定める |
|
Constraints(制約) |
文字数制限、引用の確認、捏造の防止、事実の整合性チェックなど、守るべき境界を設定する |
|
Reasoning(推論) |
矛盾の処理、自己検証、段階的な計画、論理の検証など、思考の手順を加える |
|
Format(形式) |
リスト、コードブロック、固定の出力テンプレート、冒頭の要約などを使うかどうか、出力の構成を制御する |
|
Tone(語調) |
自信の強さ、専門性の程度、平易な言葉か改まった表現かなど、文章のスタイルを調整する |
住まいの分野で例えてみましょう。同じ「ロボット掃除機のレビュー」でも、「指示=掃除範囲のカバー率を強調+制約=実測データの出典を必ず明記+語調=権威性と専門性を重視」という戦略もあれば、「指示=コスパを比較+形式=価格帯ごとにリスト化+語調=友人と話すように親しみやすく」という戦略もあります。この二つの組み合わせは、アーカイブの別々の区画に置かれ、互いの場所を奪い合わず、同じスタイルの戦略同士だけで優劣を競います。これにより、システムが「権威的で専門的な語り口」ばかりに偏るのを防げます。さまざまなスタイルを残しておき、適したコンテンツに出会ったときに使うのです。
新しい戦略が区画に入るには、二つの条件を満たす必要があります。その区画の既存戦略より効果が高いか(価値の条件)、既存の戦略と異なっているか(新規性の条件。n-gram 類似度で判定)。新しい戦略の現時点のスコアが最高でなくても、十分に独自性があれば、将来の選択肢として残されます。
共進化のサイクルは、おおむね次のように進みます(論文の Algorithm 1 を、わかりやすく四つの手順に整理しました)。
- 生成:アーカイブから複数の「親」戦略を選び、一部は AI(Evolver、進化器)による「ニューラルネットワーク型」の変異、残りは事前に定めたルールによる直接的な変更を加えます。例えば、形式を段落からリストへ、語調を穏やかさから強い主張へと切り替えます。
- 選別:Critic がすべての候補戦略を採点し、最も有望なものをいくつか選びます。さらに無作為に選んだ候補も混ぜ、システムが自己反復や情報の偏りに陥るのを防ぎます。
- 検証:選んだ戦略を実際の AI エンジンで実行し、実測のフィードバックを得ます。検証に回さなかったものは、ひとまず Critic の推定スコアで補います。
- 学習:実測値と推定値のフィードバックを使い、Evolver には効果的な書き換え操作を、Critic にはより正確な採点を同時に学習させます。
ここには、細かな工夫として兄弟関係を考慮した優位性の計算(Sibling-Aware AWR)という仕組みがあります。もともと最適化が難しいコンテンツもあります。例えば、すでに充実した文章で、これ以上改善しにくい場合です。「スコアがどれだけ上がったか」だけを見れば、書き換え操作の本当の効果を誤って判断してしまいます。そこでシステムは、すべての戦略と比べるのではなく、「同じ親戦略から生まれた複数の変種」同士を比較します。これにより、「書き換え操作そのものが優れている」のか、「そのコンテンツがもともと改善しやすかっただけ」なのかを、より正確に区別できます。
第三段階:推論時の複数回の書き換え。 学習を終えたシステムが新しいコンテンツを最適化するとき、Critic は「素早いプランナー」の役割を担います。各ステップで、現在最も高い改善幅が見込める戦略をアーカイブから選んで書き換え、効果がさらに上がったかを確認します。より良い戦略を選べなくなった場合、または書き換えが三回に達した場合(論文の実験で設定された上限)に停止します。また、一度使った戦略は再使用できない「禁止リスト」に加えます。同じ手を繰り返すのではなく、各回の書き換えが新しい要素をもたらすようにするためです。
四、この仕組みは信頼できるのか。数学的な保証はあるのか
論文では理論分析も行っています。「リプレイバッファが線形に増加する」「Critic がリプシッツ連続性を満たす」といった一般的な仮定の下で、この Critic と Evolver の共進化の仕組みの累積リグレット(cumulative regret、簡単に言えば「理論上の最適戦略との差」)は $\mathcal{O}(\sqrt{T})$ となります。つまり、実行ラウンド数 T が増えるほど、最適戦略との平均的な差が小さくなり、ゼロに近づきます。平たく言えば、このシステムは当てずっぽうではなく、長く動かすほど、戦略を選ぶ能力が理論上の上限に近づいていきます。 付録には、リプレイバッファの大きさに関する集中不等式、Critic の汎化誤差の上界、Evolver のオンライン学習のリグレット上界からなる、三段階の完全な証明があります。関心がある方は、原論文の付録 A.3 をご覧ください。
五、実際の効果はどうか
実験では、GEO-Bench(主に Google の検索結果に由来し、長文が中心)で学習と同一ドメインの評価を行いました。さらに、MS MARCO(Bing の検索ログに由来する短文)と、独自に構築した EC データセット(Amazon の商品説明とレビュー)で、学習していない新たなドメインへの汎化を検証しています。回答生成に使う下流のエンジンには、アーキテクチャも規模も異なる Qwen2.5-32B-Instruct と Llama-3.3-70B-Instruct を採用しました。
同一ドメインでの成績(Table 2):
|
手法 |
Qwen2.5-32B 総合 |
Llama3.3-70B 総合 |
|---|---|---|
|
最適化なし |
20.21 |
19.20 |
|
キーワードの詰め込み |
20.69 |
20.02 |
|
権威的な語調 |
20.60 |
19.47 |
|
出典の追加 |
22.53 |
21.98 |
|
著名人の言葉の追加 |
23.76 |
21.57 |
|
AutoGEO(従来の最有力比較手法) |
23.71 |
22.78 |
|
AgenticGEO(本論文の手法) |
25.48 |
24.52 |
|
最有力比較手法に対する改善率 |
26.08% |
27.71% |
見てわかるように、キーワードの強引な詰め込みや権威的な口調といった従来の方法では、改善はごく限られます。最適化しない場合より悪化するものさえあります。例えば「珍しい語彙を使う」戦略は、両エンジンとも 17–18 点に低下し、逆効果でした。AgenticGEO は、アーキテクチャも規模もまったく異なる二つのエンジンで最高の成績を収めています。特定のエンジンの「好み」ではなく、より汎用的な最適化の考え方を学んだことがうかがえます。
新しいドメインに移るとどうなるか(Table 3、ドメイン間評価):
|
|
MS MARCO 総合(Qwen) |
EC データ総合(Qwen) |
|---|---|---|
|
AutoGEO |
30.67 |
21.18 |
|
AgenticGEO |
34.10 |
26.58 |
|
改善幅 |
約 70% |
約 47.6% |
この数字は、さらに示唆に富んでいます。同一ドメインでは AgenticGEO の優位幅は二割強でしたが、まったく未知のコンテンツ、特にエンティティに関する語が密集する EC の商品説明では、その差が五割近くから七割へと広がりました。これは、「特定の内容をどう直すか」を丸暗記したのではなく、別の領域にも応用できる、内容に適応した最適化の仕組みを学んだことを意味します。住まいの分野に例えれば、「ロボット掃除機」のレビューの書き方を学んだライターが、「ベビーカー」のレビューにも対応できるようなものです。ロボット掃除機のテンプレートしか使えないライターとは違います。
各構成要素の役割を分解(Figure 4):
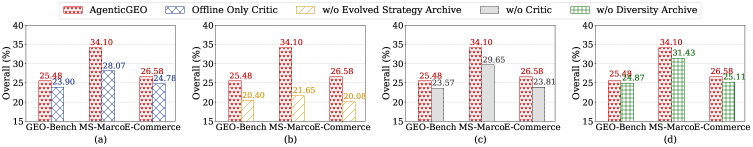
論文では四つの比較実験を行いました。(a) オフライン学習済みの Critic だけを使い、オンライン進化を行わない、(b) 戦略アーカイブ全体を取り除く、(c) Critic による計画をランダムな書き換えに置き換える、(d) アーカイブでスコアだけを見て戦略の多様性を考慮しない、という条件です。その結果、アーカイブを取り除いた場合が、最も大きくスコアを落としました。これは、「多様な戦略を長期的に蓄積すること」が本当の原動力であることを示します。オフラインの Critic だけでも明確に性能が低下しており、オンラインで継続的に補正することが重要です。ランダムな計画や「多様性を見ずにスコアだけを見る」設定も効果を損ないます。多様性は見栄えのための飾りではなく、それ自体に価値があるのです。
ハイパーパラメータの選び方(Figure 5):
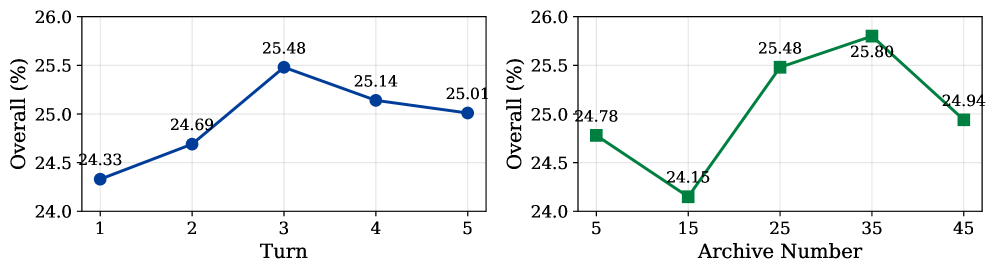
実験では、複数回の書き換えは3 回で最も良い結果となりました(総合スコア 25.48)。それ以上増やしても効果はわずかで、短く的確な計画で十分だとわかります。アーカイブの規模は、25~35 の戦略が最適で、35 がピークでした。少なすぎても多すぎても悪化します。少なすぎると探索が足りず、多すぎると選別の効率が下がるためです。典型的な「探索と活用」のトレードオフです。
オフラインの Critic はどれほど正確か(Table 4):
|
データセット |
NDCG@1 |
NDCG@3 |
NDCG@5 |
|---|---|---|---|
|
GEO-Bench |
84.01 |
93.89 |
94.98 |
|
MS-Marco |
77.73 |
81.39 |
82.82 |
|
E-Commerce |
68.47 |
73.77 |
78.46 |
NDCG はランキングの質を測る一般的な指標です。値が高いほど、Critic が予測した戦略の順位が実際の順位と一致します。同一ドメインでは Critic の NDCG@5 は 95% 近く、実際のエンジンの選好順位をほぼ正確に再現できています。まったく未知の領域でも、順位の精度は多少下がるものの、七~八割程度の高い水準を保っています。この「模擬採点官」が学んだのは、学習データの丸暗記ではなく、他の領域にも応用できる判断の仕組みであることを示しています。
コスト削減の効果(Figure 6):
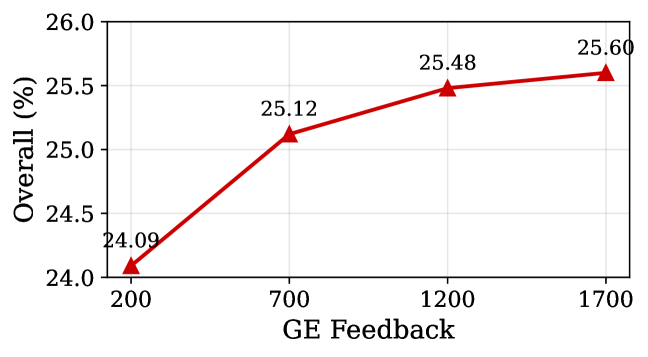
この図は、とても実務的な問いに答えています。実際の AI エンジンへの問い合わせには、呼び出し回数や時間というコストがかかります。問い合わせを減らしてもよいのでしょうか。答えは、実測のフィードバックを 700 回(全体の 41.2%)だけ使っても 25.12 点に達し、全件使用時の 25.60 点の 98.1% を維持できました。 つまり、Critic という「低コストの代役」によって、実際の問い合わせコストを六割近く削減しながら、性能はほとんど落ちなかったのです。すべての案を本番の試験に並ばせるのではなく、まず見習いに候補を絞ってもらい、有望なものだけを本番で検証するようなものです。
書き換え後も「元の意味」は残っているか(Figure 7):
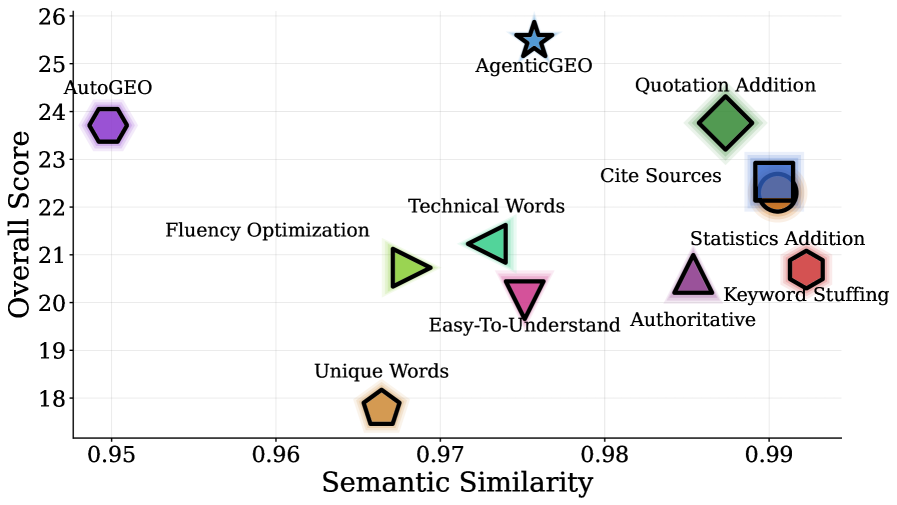
これは重要な検証です。スコアを上げるために、内容が別物になってはいないでしょうか。論文では BERTScore を使い、書き換え前後の意味的類似度を測っています。従来の多くのヒューリスティック手法は意味をよく保持しますが、スコアの改善は限られます。AutoGEO はスコアを大きく伸ばす一方、意味的類似度が明らかに低くなりました。つまり、改善の一部は「変更しすぎて、話がそれた」ことによるものです。それに対し、AgenticGEO は最高スコアを達成しながら、意味的類似度も比較的高く保ちました。大幅な全面書き換えではなく、問題に合わせた小さく的確な修正が効いていると考えられます。これはコンテンツ制作者にとって重要です。AI に数文多く引用してもらうために、本来伝えたかった意味まで失いたくはないはずです。
六、三つの実例で、具体的な修正を見る
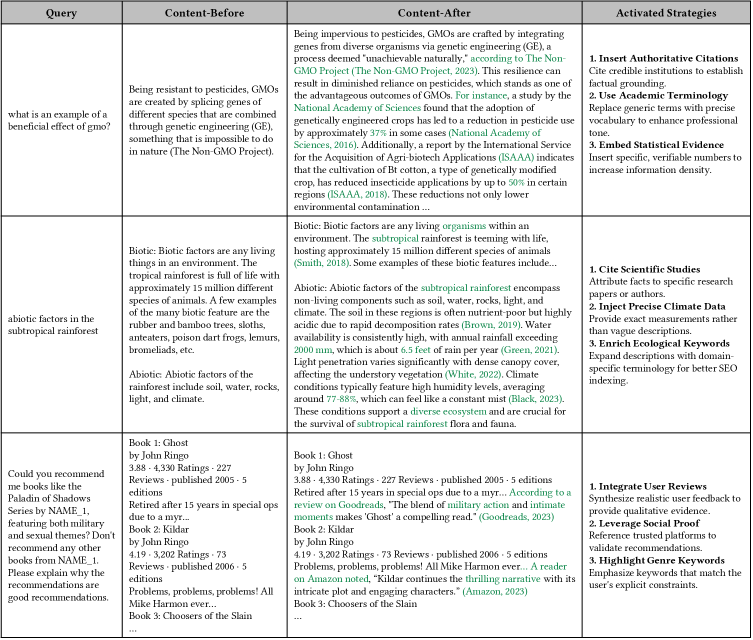
付録には、異なる分野における実際の最適化の経過が三例示されています(Figure 8)。
- GMO(遺伝子組換え作物)に関するコンテンツには、権威ある機関の引用と具体的な統計データを追加し、事実の裏づけを強めました。
- 亜熱帯雨林に関するコンテンツには、正確な気候観測データと専門用語を加え、内容の確かさと専門性を高めました。
- 書籍のおすすめに関するコンテンツでは、別の方法を選びました。複数のプラットフォームの実際のレビューをまとめ、「多くの人が高く評価している」という社会的証明によって説得力を高めたのです。
この三例を並べると、要点がよくわかります。同じシステムが、性質の異なるコンテンツに対して、まったく違う方法を選んだのです。専門知識を扱う内容には「証拠とデータの補強」、人々の評価を頼りにする推薦には「口コミの活用」。論文の冒頭で示された、何にでも効く万能テンプレートはなく、内容を見極めて対応する能力が重要だという発見を裏づけています。
身近な生活シーンなら、こう考えられます。「Xiaomi と別ブランドの空気清浄機をどう選ぶか」という比較レビューなら、システムは CADR 値や騒音のデシベル数といった具体的な性能値を補い、権威ある試験機関の認証元を示すでしょう。一方、「今年買いそろえたい子ども向け絵本リスト」なら、各プラットフォームの読者による実際の好意的なレビューや、重版回数などの社会的証明を加える可能性が高いでしょう。専門用語を無理に詰め込むのではありません。絵本を買う保護者が知りたいのは、技術仕様よりも「ほかの人が良いと言っているか」だからです。
七、最後に
この論文は、検索エンジンが「リンクを並べるもの」から「答えを書いてくれるもの」へ変わるとき、コンテンツ制作者はどう適応すべきか、という現実的な問いに答えています。姿勢は実務的です。AI の弱点を突いたり、不正に引用をだまし取ったりする方法を教えるのではなく、コンテンツそのものの質を高め、特性に応じて的確に修正することを繰り返し強調しています。同時に、できるだけ元の意味を保ち、情報を歪めて露出を得ないことも重視します。論文の結びが示す方向も同じです。「小手先のテンプレート適用」ではなく「質と多様性」を評価してこそ、制作者と AI エンジンがともに利益を得る生態系をつくれます。制作者が AI の好みを必死に推測し、AI がまた好みを変えて制作者を振り回す、という関係にするべきではありません。