Cuando la IA deja de mostrar enlaces, ¿cómo consigue un contenido formar parte de la respuesta?
La IA ya no se limita a mostrar una lista de enlaces: decide en su respuesta quién será visible. El valor de AgenticGEO reside en que no aplica una plantilla universal, sino que adapta la optimización del contenido a cada contexto para encontrar las pruebas, la estructura y las expresiones con más posibilidades de ser incorporadas por la IA.
Temas
4Resumen
La IA ya no se limita a mostrar una lista de enlaces: decide en su respuesta quién será visible. El valor de AgenticGEO reside en que no aplica una plantilla universal, sino que adapta la optimización del contenido a cada contexto para encontrar las pruebas, la estructura y las expresiones con más posibilidades de ser incorporadas por la IA.
Cuando la IA deja de mostrar enlaces, ¿cómo consigue un contenido formar parte de la respuesta?
Empecemos con una situación. Antes, si querías saber «qué purificador de aire tiene la mejor relación calidad-precio», abrías un buscador, veías una lista de títulos y enlaces y entrabas a compararlos uno a uno. Ahora preguntas a un asistente de IA o a AI Overview de Google, y te redacta directamente un párrafo: «Según varias evaluaciones, la marca XX destaca en CADR y control del ruido [1], mientras que la marca YY tiene un menor costo de sustitución de filtros [2]…». La IA ha escrito la respuesta. Ya no ves diez enlaces, sino un texto que combina información de varios sitios y añade referencias numeradas.
Esto parece más cómodo para los usuarios, pero cambia por completo las reglas para quienes escriben reseñas, descripciones de productos y artículos divulgativos. Antes se competía por «en qué página y posición aparezco». Ahora importa «si la IA me incluye en su párrafo, si menciona mi nombre y cuánto espacio dedica a mis palabras». El artículo llama a esta nueva disciplina optimización para motores generativos, o Generative Engine Optimization (GEO). El trabajo se titula «AgenticGEO: A Self-Evolving Agentic System for Generative Engine Optimization» y fue publicado en arXiv en marzo de 2026 por Jiaqi Yuan y otros investigadores de la Universidad de Beihang. En términos sencillos, propone crear un asistente de optimización de contenidos capaz de evolucionar por sí mismo, que aprende a reformular textos para que la IA los incorpore y cite con mayor facilidad. Además, mejora con el uso, sin tener que preguntar continuamente a motores de IA reales si una redacción funciona.
A continuación repasaré el artículo de principio a fin con un lenguaje sencillo e incluiré sus gráficos y tablas principales.
------
I. Pensar en posiciones o en incorporación a la respuesta
El SEO tradicional busca situar una página en la primera página de resultados mediante señales como las palabras clave y los enlaces externos. Un motor generativo no se limita a ordenar tu página para mostrársela al usuario: descompone el contenido de varias fuentes y lo reorganiza en una respuesta. Con esta lógica, la posición deja de ser el objetivo final. El artículo divide los objetivos del GEO en dos:
- Visibilidad (Visibility): ¿aparece tu contenido en la respuesta generada por la IA?
- Atribución (Attribution): ¿se identifica la fuente y se incluye una referencia a ella?
Ambos aspectos determinan directamente si el usuario volverá a tu sitio y si sabrá que tú elaboraste esa información. Por eso el artículo afirma que el GEO afecta a la sostenibilidad de todo el ecosistema web: la forma en que las respuestas de la IA repartan la atención determinará, en cierta medida, cómo se distribuyen el tráfico y la visibilidad.
II. Por qué no existe una plantilla de optimización universal
El artículo comienza con un experimento revelador: aplicar por separado 9 técnicas habituales de optimización —forzar palabras clave, utilizar vocabulario más especializado, añadir fuentes autorizadas, citas de personalidades, estadísticas, etc.— al contenido del conjunto de datos GEO-Bench y comparar los resultados. La conclusión fue que ninguna técnica funciona con todos los contenidos, y en casi la mitad del contenido ninguna de las 9 técnicas consigue mejorar la situación.
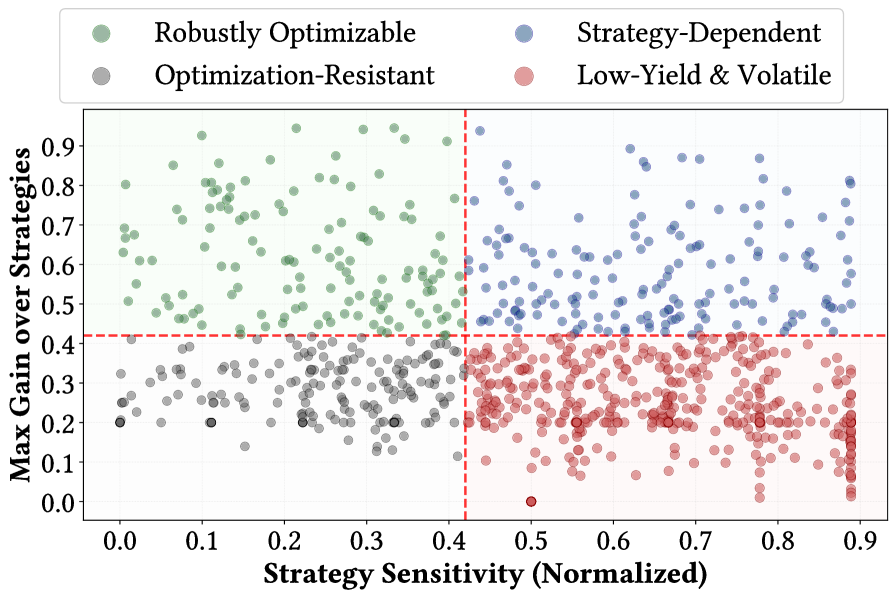
En el gráfico anterior, la Figura 1 del artículo, el eje horizontal representa la sensibilidad a la estrategia: cuanto mayor es el valor, menos estrategias funcionan, y cambiar de estrategia puede hacer perder la mejora. El eje vertical indica la ganancia máxima que puede aportar la mejor estrategia. El estudio divide las muestras en cuatro grupos: contenidos que mejoran casi con cualquier optimización (arriba a la izquierda: optimización robusta); contenidos que exigen acertar con la estrategia (arriba a la derecha: dependientes de la estrategia); contenidos en los que casi ninguna optimización sirve (abajo a la izquierda); y contenidos con resultados muy variables, donde influye mucho el azar (abajo a la derecha).
La conclusión es muy clara: reformular todos los contenidos con la misma fórmula es un error desde el principio. Pensemos en recomendaciones de productos para el hogar: una reseña de un asiento de inodoro inteligente y una de leche infantil deben destacar aspectos muy distintos. La primera debería explicar parámetros precisos de limpieza y certificaciones de seguridad; la segunda, el respaldo de organismos autorizados y las experiencias reales de familias. Aplicarles la misma plantilla probablemente no funcione bien para ninguna.
III. Cómo funciona AgenticGEO
La idea central de la solución cabe en una frase: en lugar de aferrarse a una única estrategia, mantener un repertorio completo y acompañarlo de un evaluador simulado, económico y eficaz, que ayude a elegir.
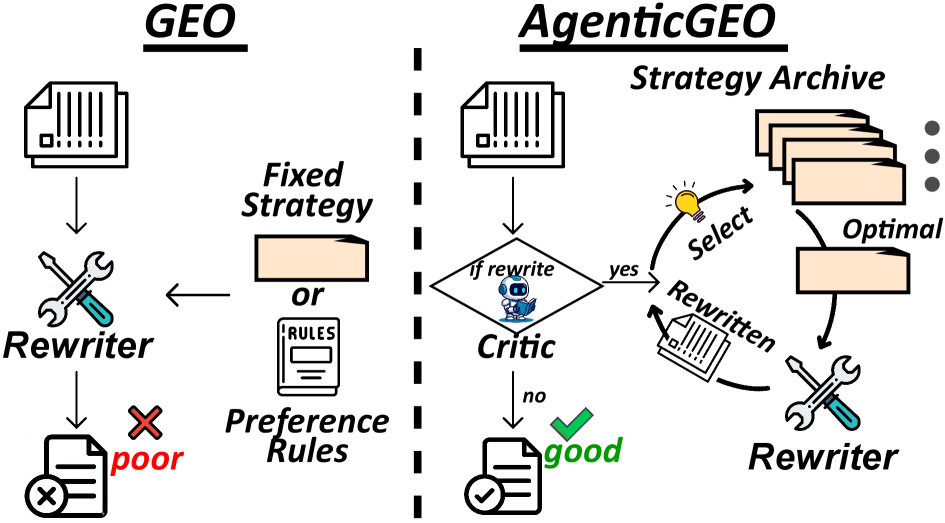
Como muestra la comparación de la Figura 2, los métodos tradicionales de GEO aplican una fórmula fija de reescritura. AgenticGEO mantiene, en cambio, un archivo de estrategias que evoluciona continuamente y utiliza un modelo de puntuación para elegir y adaptar la estrategia a cada contenido.
El sistema completo funciona en tres fases:
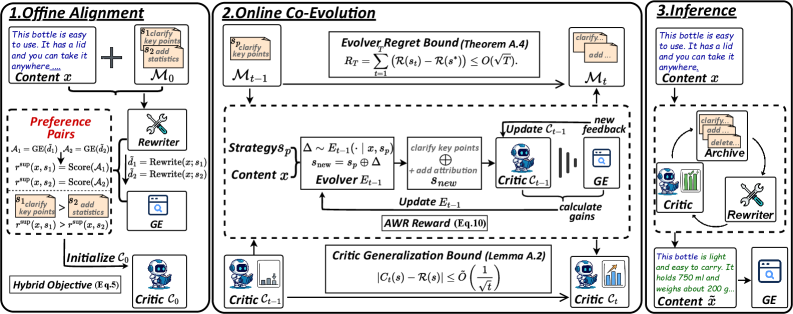
Primera fase: preparación fuera de línea. Primero se aplican 9 estrategias básicas —acumulación de palabras clave, citas de fuentes, estadísticas, etc.— a los datos de entrenamiento y se registra cuánto aumenta realmente la visibilidad con cada una. Esos datos se utilizan para entrenar un modelo ligero de puntuación, al que el artículo llama «Critic». Funciona como un evaluador sustituto de bajo costo: recibe un contenido y una estrategia candidata y estima rápidamente cuánto podría mejorar la puntuación, sin consultar al motor de IA real, algo que consume tiempo y dinero.
Segunda fase: coevolución en línea. Esta es la parte más interesante del artículo. El sistema mantiene un «archivo MAP-Elites», que puede imaginarse como un armario con compartimentos, no como una clasificación única de las mejores estrategias. Las organiza según cinco dimensiones, recogidas en la Tabla 1:
|
Dimensión |
Significado y ejemplos |
|---|---|
|
Instruction (instrucción) |
Definir el objetivo y el alcance de la reescritura: por ejemplo, el público destinatario, los hechos principales que destacar o el papel de experto que adoptar |
|
Constraints (restricciones) |
Establecer límites estrictos: extensión, comprobación de citas, prevención de información inventada y verificación de coherencia factual |
|
Reasoning (razonamiento) |
Añadir pasos lógicos: resolución de contradicciones, autocomprobación, planificación por etapas y validación lógica |
|
Format (formato) |
Controlar la presentación: por ejemplo, listas, bloques de código, plantillas de salida fijas o un resumen inicial |
|
Tone (tono) |
Ajustar el estilo de redacción: por ejemplo, grado de seguridad, nivel técnico y vocabulario sencillo o formal |
Pensemos en un ejemplo del hogar: para una misma reseña de un robot aspirador, una combinación podría ser «instrucción = destacar la cobertura de limpieza + restricción = indicar la fuente de los datos medidos + tono = experto y profesional». Otra podría ser «instrucción = comparar la relación calidad-precio + formato = listar las distintas franjas de precio + tono = cercano, como una conversación entre amigos». Estas combinaciones se guardan en compartimentos distintos del archivo: no compiten por el mismo espacio y solo se comparan con estrategias de estilo similar. Así, el sistema no converge únicamente hacia un tono experto y profesional: conserva estilos diversos y utiliza cada uno cuando encaja con el contenido.
Para entrar en un compartimento, una nueva estrategia debe cumplir dos criterios: ser más eficaz que la estrategia que ya ocupa el compartimento (criterio de valor), distinguirse de las estrategias existentes (criterio de novedad, evaluado mediante la similitud de n-gramas). Aunque su puntuación no sea la más alta en ese momento, una estrategia suficientemente original puede conservarse como alternativa para el futuro.
El ciclo de coevolución funciona, a grandes rasgos, así. Estas son las cuatro etapas del Algoritmo 1 del artículo, explicadas de forma sencilla:
- Generar: seleccionar algunas estrategias progenitoras del archivo. Una parte recibe mutaciones mediante una red neuronal, generadas por la IA «Evolver»; otra recibe cambios basados en reglas predefinidas, como pasar de párrafos a listas o de un tono moderado a uno contundente.
- Seleccionar: el Critic puntúa primero todas las estrategias candidatas. El sistema elige las más prometedoras y añade algunas al azar para evitar repetirse continuamente y quedar encerrado en una burbuja de información.
- Validar: las estrategias seleccionadas se prueban realmente en el motor de IA para obtener resultados observados. Las que no se validan mantienen, por el momento, la estimación del Critic.
- Aprender: los resultados reales y estimados se utilizan para actualizar a la vez el Evolver, enseñándole qué cambios funcionan mejor, y el Critic, mejorando la precisión de sus puntuaciones.
Un mecanismo especialmente cuidadoso se denomina «cálculo de ventaja que tiene en cuenta las estrategias hermanas (Sibling-Aware AWR)». Algunos contenidos son intrínsecamente difíciles de optimizar: por ejemplo, un texto ya muy sólido ofrece poco margen de mejora. Evaluar únicamente el aumento de puntuación podría distorsionar el efecto real de un cambio. Por eso el sistema compara entre sí las variantes nacidas de una misma estrategia progenitora, en lugar de compararlas con todas las estrategias. Así distingue mejor entre un cambio realmente eficaz y un contenido que simplemente era más fácil de mejorar.
Tercera fase: reescritura en varias rondas durante la inferencia. Una vez entrenado el sistema, el Critic actúa como un planificador rápido al optimizar contenido nuevo. En cada paso elige del archivo la estrategia con mayor mejora estimada, reescribe el contenido y comprueba si el resultado sigue mejorando. Se detiene cuando ya no encuentra una estrategia mejor o tras tres rondas de reescritura, el límite fijado en los experimentos del artículo. También mantiene una lista de exclusión para no reutilizar estrategias ya aplicadas: cada ronda debe aportar algo nuevo, en lugar de repetir la misma fórmula.
IV. ¿Es fiable el mecanismo? ¿Tiene garantías matemáticas?
El artículo presenta un análisis teórico: bajo supuestos habituales, como el crecimiento lineal del búfer de repetición y un Critic con continuidad de Lipschitz, el arrepentimiento acumulado de la coevolución entre Critic y Evolver —es decir, la diferencia acumulada frente a la estrategia teóricamente óptima— es de orden $\mathcal{O}(\sqrt{T})$. A medida que aumenta el número de rondas T, la diferencia media respecto de la estrategia óptima disminuye y tiende a cero. Dicho de forma sencilla: el sistema no se limita a probar suerte: cuanto más tiempo funciona, más se acerca, en teoría, al nivel óptimo de selección de estrategias. El apéndice del artículo incluye la demostración completa en tres pasos: una desigualdad de concentración para el tamaño del búfer de repetición, una cota del error de generalización del Critic y una cota del arrepentimiento de aprendizaje en línea del Evolver. Puede consultarse en el apéndice A.3 del texto original.
V. ¿Qué resultados obtiene?
En los experimentos, los autores utilizan GEO-Bench, compuesto principalmente por resultados de Google y textos largos, para entrenar y evaluar en el dominio de origen. También prueban dominios completamente nuevos para el sistema: MS MARCO, con textos cortos procedentes de registros de búsquedas de Bing, y un conjunto de datos de comercio electrónico creado para el estudio, con descripciones de productos y reseñas de Amazon. Como motores para generar las respuestas utilizan dos modelos de arquitecturas y tamaños distintos: Qwen2.5-32B-Instruct y Llama-3.3-70B-Instruct.
Resultados en el dominio de origen (Tabla 2):
|
Método |
Puntuación global Qwen2.5-32B |
Puntuación global Llama3.3-70B |
|---|---|---|
|
Sin optimización |
20.21 |
19.20 |
|
Acumulación de palabras clave |
20.69 |
20.02 |
|
Tono de autoridad |
20.60 |
19.47 |
|
Añadir fuentes citadas |
22.53 |
21.98 |
|
Añadir citas de personalidades |
23.76 |
21.57 |
|
AutoGEO (mejor método previo de comparación) |
23.71 |
22.78 |
|
AgenticGEO (método de este artículo) |
25.48 |
24.52 |
|
Mejora relativa frente al mejor método de comparación |
26.08% |
27.71% |
Se observa que fórmulas rudimentarias como acumular palabras clave o adoptar un tono de autoridad aportan mejoras muy limitadas y, a veces, empeoran el resultado. Por ejemplo, la estrategia de usar vocabulario menos habitual reduce las puntuaciones a 17-18 en ambos motores, por lo que resulta contraproducente. AgenticGEO obtiene los mejores resultados en dos motores de arquitecturas y tamaños muy diferentes. Esto indica que ha aprendido una lógica de optimización más general, en lugar de las particularidades de un solo motor.
¿Y en dominios nuevos? Estos son los resultados de las pruebas entre dominios de la Tabla 3:
|
|
Puntuación global MS MARCO (Qwen) |
Puntuación global de comercio electrónico (Qwen) |
|---|---|---|
|
AutoGEO |
30.67 |
21.18 |
|
AgenticGEO |
34.10 |
26.58 |
|
Magnitud de la mejora |
Aproximadamente un 70 % |
Aproximadamente un 47,6 % |
Estas cifras son especialmente reveladoras: en su dominio de origen, AgenticGEO supera al resto en más de un veinte por ciento. Al pasar a tipos de contenido completamente nuevos, sobre todo descripciones de productos de comercio electrónico con muchas entidades nombradas, su ventaja aumenta hasta cerca de un cincuenta a un setenta por ciento. Esto significa que el sistema no ha memorizado cómo reescribir una categoría de contenido, sino que ha aprendido una lógica de optimización transferible y adaptada al contenido. En un ejemplo del hogar, sería como un redactor que, tras aprender a evaluar robots aspiradores, también sabe evaluar cochecitos de bebé, en lugar de aplicar siempre una plantilla para robots aspiradores.
Función de cada componente (Figura 4):
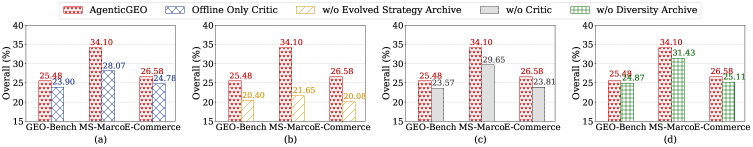
El artículo compara cuatro variantes: (a) utilizar solo el Critic entrenado fuera de línea, sin evolución en línea; (b) eliminar por completo el archivo de estrategias; (c) sustituir la planificación guiada por el Critic por reescrituras aleatorias; y (d) gestionar el archivo solo por puntuación, sin considerar la diversidad. El resultado es que eliminar el archivo provoca la mayor caída de puntuación. Por tanto, acumular a lo largo del tiempo un conjunto diverso de estrategias es el verdadero motor del sistema. Usar únicamente el Critic entrenado fuera de línea también da resultados claramente peores, lo que muestra la importancia de la calibración continua en línea. La planificación aleatoria y la selección que ignora la diversidad también perjudican el rendimiento: la diversidad tiene utilidad real, no es un adorno.
Elección de hiperparámetros (Figura 5):
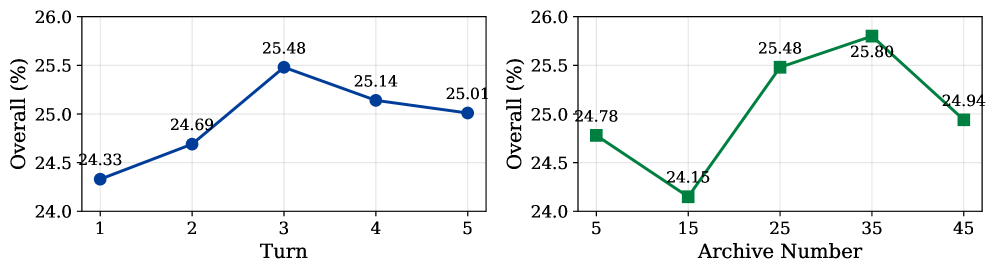
Los experimentos muestran que la reescritura sucesiva funciona mejor con 3 rondas y obtiene una puntuación global de 25,48. Añadir más rondas aporta muy poco, por lo que basta con una planificación breve y precisa. El archivo funciona mejor cuando contiene entre 25 y 35 estrategias, con un máximo en 35. Un archivo demasiado pequeño limita la exploración; uno demasiado grande reduce la eficiencia de la selección. Es el equilibrio clásico entre exploración y explotación.
¿Qué precisión tiene el Critic fuera de línea? (Tabla 4)
|
Conjunto de datos |
NDCG@1 |
NDCG@3 |
NDCG@5 |
|---|---|---|---|
|
GEO-Bench |
84.01 |
93.89 |
94.98 |
|
MS-Marco |
77.73 |
81.39 |
82.82 |
|
Comercio electrónico |
68.47 |
73.77 |
78.46 |
El NDCG es una métrica habitual de calidad de clasificación. Cuanto mayor es, más coincide el orden de las estrategias previsto por el Critic con el orden real. En el dominio de origen, su NDCG@5 se acerca al 95 %, por lo que reproduce casi con exactitud las preferencias del motor real. Incluso en dominios completamente desconocidos, la calidad solo disminuye en parte y se mantiene en torno al setenta u ochenta por ciento. Esto indica que el evaluador simulado ha aprendido una lógica de juicio transferible, en lugar de memorizar los datos de entrenamiento.
Ahorro de costos (Figura 6):
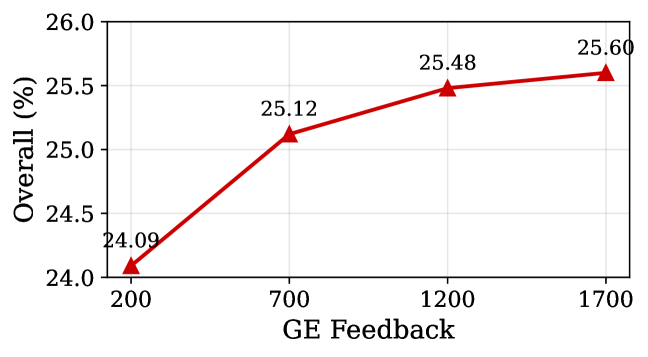
Este gráfico responde a una pregunta muy práctica: consultar realmente al motor de IA tiene un costo en llamadas y tiempo. ¿Es posible obtener buenos resultados con menos consultas? La respuesta: Con solo 700 resultados reales, el 41,2 % del total, el sistema obtiene 25,12 puntos y conserva el 98,1 % de la puntuación de 25,60 obtenida con todos los resultados. En otras palabras, el Critic, ese sustituto económico, ahorra casi un sesenta por ciento de las consultas reales con una pérdida de rendimiento mínima. Es como pedir a un aprendiz que preseleccione las propuestas y llevar al examen real solo las más prometedoras, en vez de hacer pasar todas una por una.
¿Se conserva el sentido original tras la reescritura? (Figura 7)
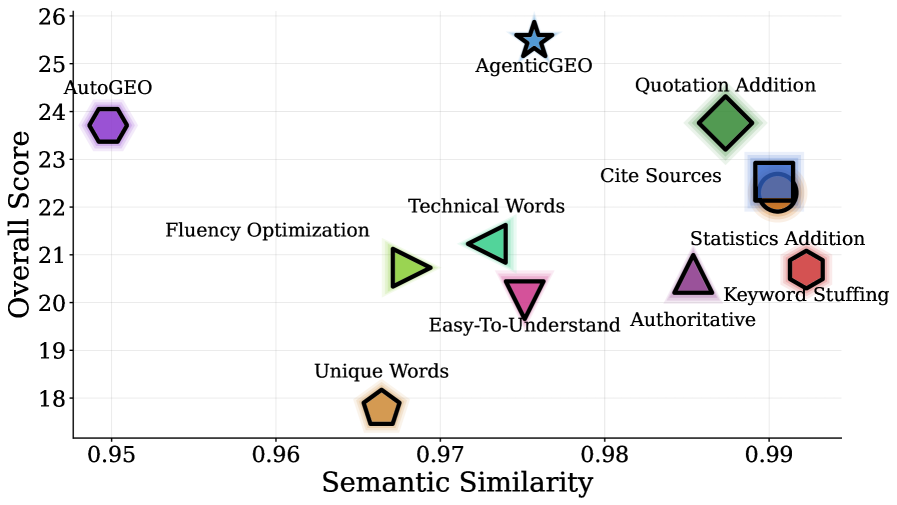
Es una comprobación importante: ¿se gana puntuación a costa de desvirtuar el contenido? El artículo utiliza BERTScore para medir la similitud semántica antes y después de la reescritura. La mayoría de los métodos heurísticos clásicos conserva bien el significado, pero mejora poco la puntuación. AutoGEO consigue mejoras mayores, aunque con una similitud semántica claramente inferior: parte de su avance procede de cambios excesivos que se alejan del tema. En cambio, AgenticGEO obtiene la puntuación más alta y mantiene una similitud semántica relativamente elevada. Esto indica que se apoya en ajustes pequeños, precisos y adecuados al caso, en lugar de reescribirlo todo. Para los creadores es importante: nadie quiere perder lo que pretendía expresar solo para conseguir algunas citas más de la IA.
VI. Tres casos reales de reescritura
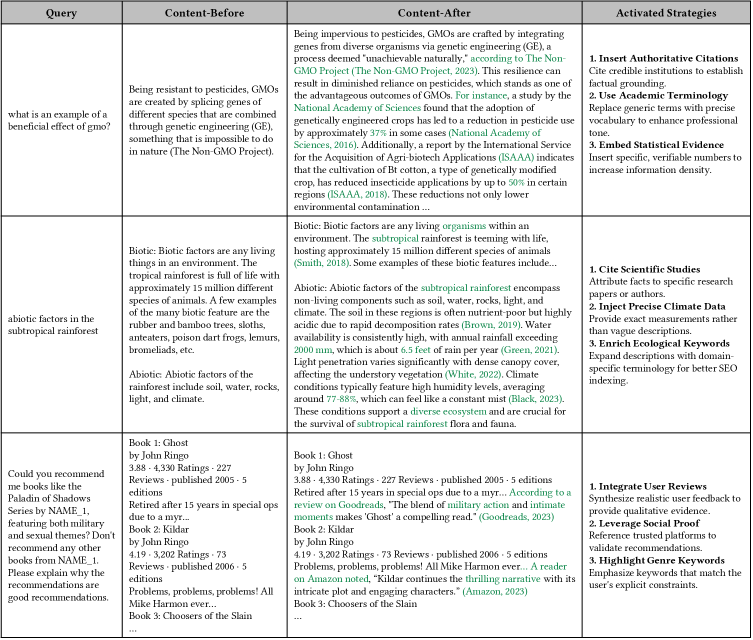
El apéndice del artículo presenta tres trayectorias reales de optimización en ámbitos distintos (Figura 8):
- Un contenido sobre OGM, cultivos modificados genéticamente, al que el sistema añade citas de organismos autorizados y estadísticas concretas para reforzar el respaldo factual;
- Un contenido sobre selvas subtropicales, enriquecido con mediciones climáticas precisas y terminología especializada para darle mayor solidez y conocimiento técnico;
- Un contenido de recomendaciones de libros, para el que el sistema sigue otra vía: reúne opiniones reales de varias plataformas y refuerza la persuasión mediante la prueba social, es decir, que muchos lectores los valoran positivamente.
En conjunto, estos tres casos ilustran bien el principio: un mismo sistema elige enfoques completamente distintos según la naturaleza del contenido. Los contenidos de conocimiento factual se refuerzan con pruebas y datos; las recomendaciones sociales, con las valoraciones colectivas. Esto confirma la conclusión inicial del artículo: no existe una plantilla universal. La clave es que el sistema aprenda a adaptar su enfoque a cada situación.
En una situación más cotidiana, puede imaginarse lo siguiente: para una comparativa como «¿Cómo elegir entre un purificador de aire Xiaomi y uno de otra marca?», el sistema probablemente añadiría cifras concretas de CADR y ruido en decibelios, junto con las fuentes de certificación de organismos de ensayo reconocidos. Para una lista de los álbumes infantiles que más merece la pena comprar este año, sería más probable que añadiera opiniones positivas reales de lectores de distintas plataformas y señales de prueba social, como el número de reimpresiones, en vez de acumular tecnicismos. Los padres que compran álbumes quieren conocer sobre todo la opinión de los demás, no revisar especificaciones técnicas.
VII. Para terminar
Este artículo responde a una cuestión muy actual: ¿cómo deben adaptarse los creadores cuando el buscador pasa de ofrecer una lista de enlaces a redactar directamente la respuesta? Su planteamiento es pragmático. No enseña a explotar fallos de la IA ni a conseguir citas mediante trampas, sino que insiste en mejorar la calidad intrínseca del contenido y ajustarlo de forma precisa a sus características. También busca conservar el significado y evitar ganar visibilidad a costa de distorsionar la información. Esa es la dirección que señala su conclusión: recompensar la calidad y la diversidad, en lugar de la aplicación oportunista de plantillas, permite crear un ecosistema beneficioso tanto para los creadores como para los motores de IA, en vez de una carrera en la que los creadores intentan adivinar continuamente qué prefiere la IA y esta cambia sus preferencias sin cesar.