Quand l’IA ne propose plus de liens, comment faire adopter son contenu dans les réponses ?
L’IA ne se contente plus d’afficher une liste de liens : elle décide, dans sa réponse, qui sera visible. L’intérêt d’AgenticGEO est de ne pas appliquer un modèle universel, mais d’adapter l’optimisation du contenu au contexte afin de trouver les preuves, la structure et les formulations les plus susceptibles d’être retenues par l’IA.
Thèmes
4Résumé
L’IA ne se contente plus d’afficher une liste de liens : elle décide, dans sa réponse, qui sera visible. L’intérêt d’AgenticGEO est de ne pas appliquer un modèle universel, mais d’adapter l’optimisation du contenu au contexte afin de trouver les preuves, la structure et les formulations les plus susceptibles d’être retenues par l’IA.
Quand l’IA ne propose plus de liens, comment faire adopter son contenu dans les réponses ?
Commençons par une situation concrète. Autrefois, pour savoir « quel purificateur d’air offre le meilleur rapport qualité-prix », vous ouvriez un moteur de recherche, parcouriez une liste de titres et de liens, puis compariez les pages une par une. Aujourd’hui, vous interrogez un assistant IA ou AI Overview de Google, et il vous rédige directement un paragraphe : « D’après plusieurs essais, la marque XX se distingue par son CADR et sa maîtrise du bruit [1], tandis que la marque YY propose des filtres moins coûteux à remplacer [2]… » L’IA a elle-même rédigé la réponse. Vous ne voyez plus dix liens, mais un texte qui combine les informations de plusieurs sites et comporte des références numérotées.
Cela semble plus pratique pour les utilisateurs, mais les règles du jeu ont complètement changé pour les auteurs de tests, de fiches produits et d’articles de vulgarisation. Avant, la compétition portait sur « la page et la position dans les résultats ». Désormais, elle porte sur « ma présence dans le paragraphe de l’IA, la mention de mon nom et la place accordée à mes propos ». L’article appelle cette nouvelle discipline l’optimisation pour les moteurs génératifs, ou Generative Engine Optimization (GEO). Intitulée « AgenticGEO : A Self-Evolving Agentic System for Generative Engine Optimization », cette étude de Jiaqi Yuan et d’autres chercheurs de l’université Beihang a été publiée sur arXiv en mars 2026. Son idée est simple : créer un assistant d’optimisation du contenu capable d’évoluer de lui-même, qui cherche comment reformuler vos textes pour que l’IA les retienne et les cite plus facilement. Cet assistant s’améliore avec l’usage, sans vous obliger à interroger sans cesse de véritables moteurs d’IA pour savoir si une formulation fonctionne.
Je vais maintenant parcourir cette étude de bout en bout en termes simples, en reprenant ses principaux graphiques et tableaux.
------
I. Raisonner en classement ou en intégration à la réponse
Le SEO traditionnel cherche à placer une page sur la première page des résultats, en s’appuyant notamment sur les mots-clés et les liens entrants. Un moteur génératif, lui, ne classe pas simplement votre page pour la montrer à l’utilisateur : il décompose les contenus de plusieurs sources et les réorganise en une réponse. Dans cette logique, le classement n’est plus la finalité. L’étude distingue deux objectifs pour le GEO :
- Visibilité (Visibility) : votre contenu figure-t-il dans la réponse générée par l’IA ?
- Attribution (Attribution) : la source est-elle indiquée et accompagnée d’une référence ?
Ces deux éléments déterminent directement si l’utilisateur reviendra sur votre site et saura que vous êtes à l’origine de l’information. Voilà pourquoi l’étude affirme que le GEO concerne la pérennité de l’ensemble de l’écosystème du Web : la manière dont les réponses de l’IA répartissent l’attention conditionnera, dans une certaine mesure, la répartition du trafic et de la visibilité.
II. Pourquoi il n’existe pas de modèle d’optimisation universel
L’étude commence par une expérience assez révélatrice : appliquer séparément 9 techniques d’optimisation courantes — ajout forcé de mots-clés, vocabulaire plus spécialisé, références faisant autorité, citations de personnalités, statistiques, etc. — aux contenus du jeu de données GEO-Bench, puis comparer leurs résultats. Le constat est le suivant : aucune technique ne fonctionne pour tous les contenus, et pour près de la moitié d’entre eux, aucune des 9 techniques ne permet d’améliorer la situation.
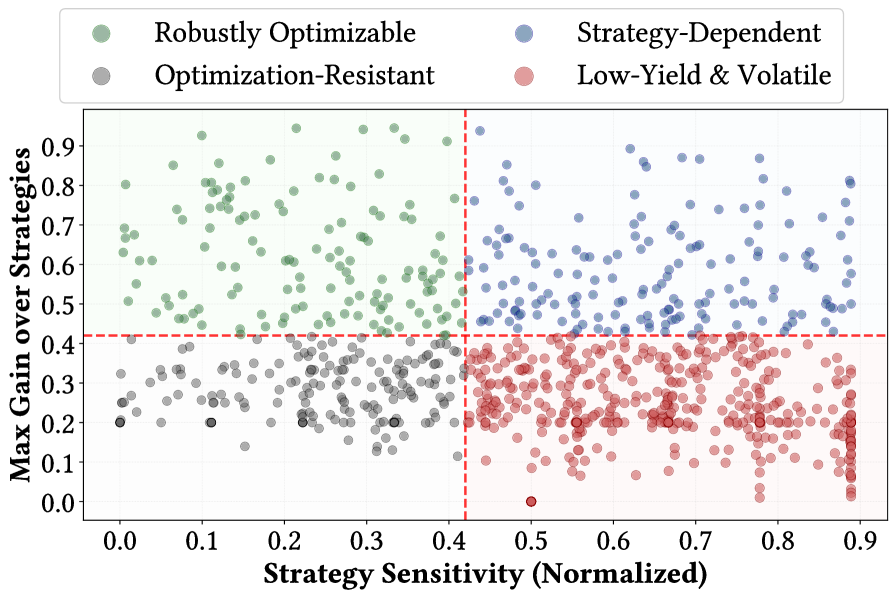
Sur le graphique ci-dessus, la Figure 1 de l’étude, l’axe horizontal représente la sensibilité à la stratégie : plus elle est élevée, moins il y a de stratégies efficaces, et en changer peut annuler les gains. L’axe vertical représente le gain maximal obtenu avec la meilleure stratégie. L’étude classe les échantillons en quatre catégories : certains contenus progressent quelle que soit l’optimisation choisie (en haut à gauche : optimisation robuste) ; d’autres nécessitent de choisir précisément la bonne stratégie (en haut à droite : dépendance à la stratégie) ; certains résistent à presque toute optimisation (en bas à gauche) ; enfin, d’autres donnent des résultats très variables, avec une forte part d’aléatoire (en bas à droite).
La conclusion est très claire : reformuler tous les contenus avec la même recette est une erreur dès le départ. Prenons des recommandations de produits pour la maison : un test de siège de toilette intelligent et un test de lait infantile ne doivent pas mettre l’accent sur les mêmes éléments. Le premier doit détailler les paramètres de nettoyage et les certifications de sécurité ; le second doit présenter l’appui d’organismes reconnus et les retours réels des familles. Appliquer le même modèle aux deux risque fort de ne convenir à aucun.
III. Comment fonctionne AgenticGEO
L’idée centrale de la solution proposée tient en une phrase : au lieu de s’en tenir à une stratégie unique, constituer tout un répertoire de stratégies et lui adjoindre un évaluateur de substitution, économique et efficace, pour aider à choisir.
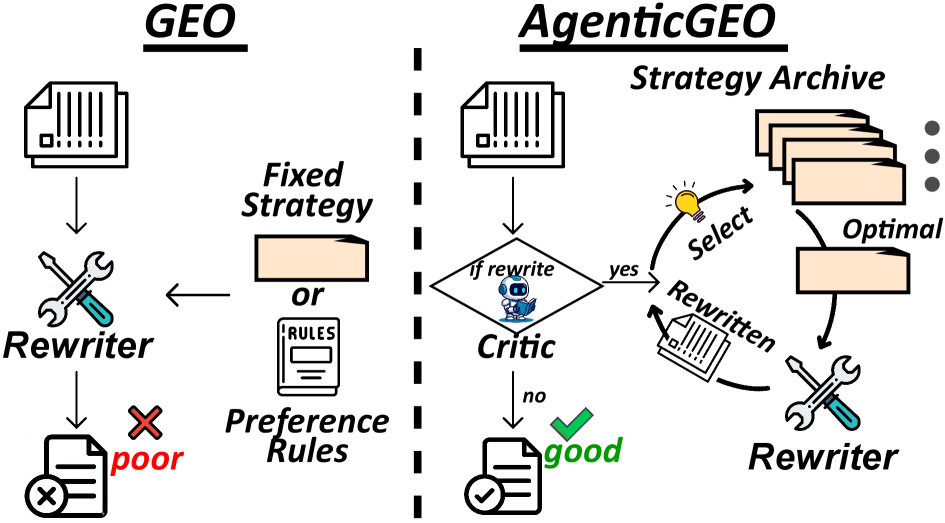
Comme le montre la comparaison ci-dessus, en Figure 2, les méthodes GEO traditionnelles appliquent une formule de réécriture figée. AgenticGEO entretient au contraire un répertoire de stratégies en évolution continue et utilise un modèle de notation pour choisir et adapter la stratégie à chaque contenu.
L’ensemble du système fonctionne en trois phases :
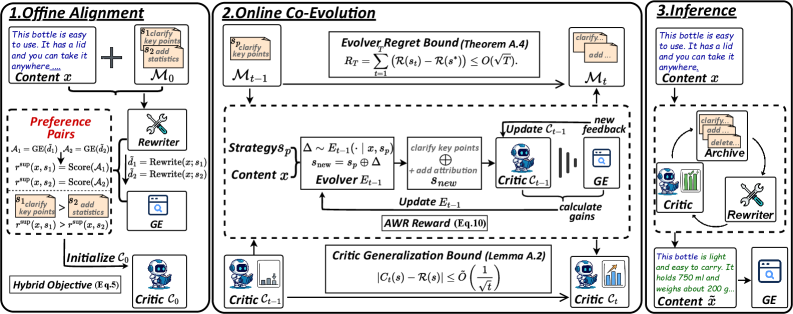
Première phase : préparation hors ligne. On commence par appliquer 9 stratégies de base — accumulation de mots-clés, citation de sources, ajout de statistiques, etc. — aux données d’entraînement, en enregistrant le gain réel de visibilité obtenu pour chacune. Ces observations servent à entraîner un modèle de notation léger, appelé « Critic » dans l’étude. Il joue le rôle d’un évaluateur de substitution peu coûteux : à partir d’un contenu et d’une stratégie candidate, il estime rapidement le gain de score probable, sans avoir à interroger le moteur d’IA réel, ce qui coûte du temps et de l’argent.
Deuxième phase : coévolution en ligne. C’est la partie la plus intéressante de l’étude. Le système entretient une « archive MAP-Elites », que l’on peut imaginer comme un meuble à compartiments, plutôt que comme un classement unique des meilleures stratégies. Il classe celles-ci selon cinq dimensions, présentées dans le Tableau 1 :
|
Critère |
Signification et exemples |
|---|---|
|
Instruction (consigne) |
Définir l’objectif et le périmètre de la réécriture : public visé, faits essentiels à mettre en avant, rôle d’expert à adopter, par exemple |
|
Constraints (contraintes) |
Fixer des limites strictes : longueur du texte, vérification des références, prévention des informations inventées, contrôle de la cohérence factuelle |
|
Reasoning (raisonnement) |
Ajouter des étapes logiques : gestion des contradictions, autocontrôle, planification par étapes, validation du raisonnement |
|
Format (présentation) |
Définir la présentation : listes, blocs de code, modèles de sortie fixes ou résumé introductif, par exemple |
|
Tone (ton) |
Ajuster le style rédactionnel : degré d’assurance, niveau de technicité, vocabulaire simple ou formel, par exemple |
Prenons un exemple dans l’univers de la maison : pour un même test d’aspirateur robot, une combinaison peut être « consigne = insister sur la couverture de nettoyage + contrainte = citer la source des mesures réelles + ton = expert et professionnel ». Une autre peut être « consigne = comparer le rapport qualité-prix + format = présenter chaque gamme de prix sous forme de liste + ton = accessible, comme une discussion entre amis ». Ces deux combinaisons occupent des compartiments différents dans l’archive : elles ne se disputent pas la même place et ne sont comparées qu’aux stratégies de style similaire. Ainsi, le système ne converge pas uniquement vers un ton d’expert faisant autorité. Il conserve une diversité de styles et utilise chacun lorsque le contenu s’y prête.
Pour entrer dans un compartiment, une nouvelle stratégie doit satisfaire deux critères : être plus efficace que la stratégie déjà présente dans le compartiment (critère de valeur), se distinguer des stratégies existantes (critère de nouveauté, évalué par la similarité des n-grammes). Même si son score n’est pas le meilleur à cet instant, une stratégie suffisamment originale peut être conservée comme possibilité pour l’avenir.
Le cycle de coévolution fonctionne globalement ainsi. Voici l’Algorithme 1 de l’étude reformulé en quatre étapes simples :
- Générer : sélectionner quelques stratégies parentes dans l’archive. Une partie subit des mutations par réseau neuronal, produites par l’IA « Evolver » ; une autre subit des modifications selon des règles prédéfinies, comme passer des paragraphes aux listes ou d’un ton modéré à un ton affirmé.
- Sélectionner : le Critic note d’abord toutes les stratégies candidates. Le système retient les plus prometteuses, puis en ajoute quelques-unes au hasard pour éviter de répéter toujours les mêmes idées et de s’enfermer dans une bulle d’information.
- Valider : les stratégies retenues sont réellement testées auprès du moteur d’IA pour obtenir un retour concret. Celles qui ne sont pas testées conservent provisoirement l’estimation du Critic.
- Apprendre : les retours réels et estimés servent à mettre à jour simultanément l’Evolver, pour lui apprendre quelles modifications sont les plus efficaces, et le Critic, pour améliorer la précision de ses notes.
Un mécanisme particulièrement soigné porte le nom de « calcul de l’avantage tenant compte des stratégies sœurs (Sibling-Aware AWR) ». Certains contenus sont intrinsèquement difficiles à optimiser : par exemple, un texte déjà très solide offre peu de marge de progression. Se fonder uniquement sur le gain de score pourrait donc fausser l’évaluation d’une modification. Le système compare entre elles les variantes issues d’une même stratégie parente, plutôt que de les confronter à toutes les stratégies. Il distingue ainsi mieux une modification réellement efficace d’un contenu simplement plus facile à améliorer.
Troisième phase : réécritures successives à l’inférence. Une fois le système entraîné, le Critic joue le rôle de planificateur rapide pour optimiser un nouveau contenu. À chaque étape, il sélectionne dans l’archive la stratégie dont le gain estimé est le plus élevé, applique la réécriture, puis vérifie si la performance continue de progresser. Il s’arrête lorsqu’aucune meilleure stratégie n’est disponible ou après trois réécritures, la limite fixée dans les expériences de l’étude. Une liste d’exclusion empêche de réutiliser une stratégie déjà appliquée : chaque réécriture doit apporter quelque chose de nouveau au lieu de répéter la même recette.
IV. Le mécanisme est-il fiable ? Existe-t-il une garantie mathématique ?
L’étude propose une analyse théorique : sous des hypothèses courantes, telles qu’une croissance linéaire du tampon de rejeu et un Critic lipschitzien, le regret cumulé de cette coévolution entre Critic et Evolver — autrement dit, l’écart cumulé avec la stratégie théoriquement optimale — est de l’ordre de $\mathcal{O}(\sqrt{T})$. À mesure que le nombre de tours T augmente, l’écart moyen avec la stratégie optimale diminue et tend vers zéro. En termes simples : le système ne se contente pas d’essayer au hasard : plus il fonctionne longtemps, plus sa capacité théorique à choisir les stratégies se rapproche de l’optimum. L’annexe de l’étude présente la démonstration complète en trois étapes : inégalité de concentration de la taille du tampon de rejeu, borne d’erreur de généralisation du Critic et borne du regret d’apprentissage en ligne de l’Evolver. Les lecteurs intéressés peuvent consulter l’annexe A.3 du texte original.
V. Quels sont les résultats ?
Pour les expériences, les auteurs utilisent GEO-Bench, principalement composé de résultats Google et de textes longs, pour l’entraînement et l’évaluation dans le domaine d’origine. Ils testent aussi des domaines entièrement nouveaux pour le système : MS MARCO, constitué de textes courts provenant des journaux de recherche Bing, et un jeu de données de commerce en ligne créé pour l’étude, composé de descriptions de produits et d’avis Amazon. Deux modèles d’architectures et de tailles différentes servent de moteurs de génération des réponses : Qwen2.5-32B-Instruct et Llama-3.3-70B-Instruct.
Résultats dans le domaine d’origine (Tableau 2) :
|
Méthode |
Score global Qwen2.5-32B |
Score global Llama3.3-70B |
|---|---|---|
|
Sans optimisation |
20.21 |
19.20 |
|
Accumulation de mots-clés |
20.69 |
20.02 |
|
Ton faisant autorité |
20.60 |
19.47 |
|
Ajout de sources citées |
22.53 |
21.98 |
|
Ajout de citations de personnalités |
23.76 |
21.57 |
|
AutoGEO (meilleure méthode de comparaison antérieure) |
23.71 |
22.78 |
|
AgenticGEO (méthode de cette étude) |
25.48 |
24.52 |
|
Gain relatif par rapport à la meilleure méthode de comparaison |
26.08 % |
27.71 % |
On constate que les recettes rudimentaires, comme l’accumulation de mots-clés ou l’adoption d’un ton d’autorité, apportent des gains très limités, voire dégradent les résultats. Par exemple, la stratégie consistant à utiliser un vocabulaire plus rare fait chuter les scores entre 17 et 18 sur les deux moteurs : elle est donc contre-productive. AgenticGEO obtient les meilleurs résultats sur deux moteurs d’architectures et de tailles très différentes. Cela suggère qu’il a appris une logique d’optimisation plus générale, plutôt que les particularités d’un seul moteur.
Et dans de nouveaux domaines ? Voici les tests interdomaines du Tableau 3 :
|
|
Score global MS MARCO (Qwen) |
Score global commerce en ligne (Qwen) |
|---|---|---|
|
AutoGEO |
30.67 |
21.18 |
|
AgenticGEO |
34.10 |
26.58 |
|
Ampleur du gain |
Environ 70 % |
Environ 47,6 % |
Ces chiffres sont particulièrement révélateurs : dans son domaine d’origine, AgenticGEO devance la concurrence de plus de vingt pour cent. Sur des contenus entièrement nouveaux, notamment les descriptions de produits de commerce en ligne, riches en entités nommées, son avance atteint près de cinquante à soixante-dix pour cent. Le système n’a donc pas simplement mémorisé comment réécrire une catégorie de contenus : il a appris une logique d’optimisation transférable et adaptée au contenu. Pour reprendre un exemple lié à la maison, c’est comme un rédacteur qui, après avoir appris à tester des aspirateurs robots, sait aussi tester des poussettes, plutôt que d’appliquer partout un modèle conçu pour les aspirateurs robots.
Rôle de chaque composant (Figure 4) :
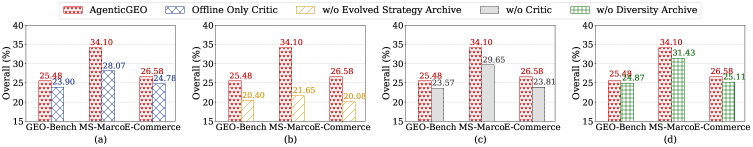
L’étude compare quatre variantes : (a) utiliser uniquement le Critic entraîné hors ligne, sans évolution en ligne ; (b) supprimer entièrement l’archive de stratégies ; (c) remplacer la planification guidée par le Critic par des réécritures aléatoires ; (d) gérer l’archive selon les seuls scores, sans tenir compte de la diversité. Le résultat : la suppression de l’archive provoque la plus forte baisse de score. Accumuler durablement un ensemble de stratégies diverses constitue donc le véritable moteur du système. Le Critic uniquement entraîné hors ligne est aussi nettement moins performant, ce qui souligne l’importance d’un recalibrage continu en ligne. La planification aléatoire et la sélection ignorant la diversité dégradent également les résultats : la diversité a une utilité réelle, ce n’est pas un simple ornement.
Choix des hyperparamètres (Figure 5) :
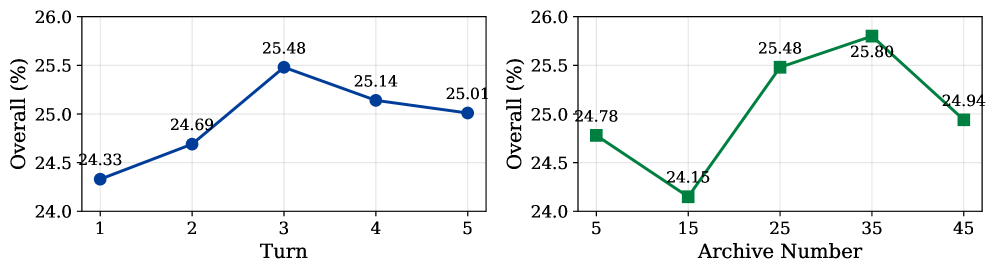
Les expériences montrent que les réécritures successives sont les plus efficaces avec 3 tours, pour un score global de 25,48. Ajouter des tours n’apporte ensuite que peu de bénéfices : une planification courte et ciblée suffit. L’archive est la plus efficace lorsqu’elle contient 25 à 35 stratégies, avec un pic à 35. Une archive trop petite limite l’exploration ; une archive trop grande nuit à l’efficacité de la sélection. C’est un compromis classique entre exploration et exploitation.
Quelle est la précision du Critic hors ligne ? (Tableau 4)
|
Jeu de données |
NDCG@1 |
NDCG@3 |
NDCG@5 |
|---|---|---|---|
|
GEO-Bench |
84.01 |
93.89 |
94.98 |
|
MS-Marco |
77.73 |
81.39 |
82.82 |
|
Commerce en ligne |
68.47 |
73.77 |
78.46 |
Le NDCG est un indicateur courant de qualité du classement. Plus il est élevé, plus le classement des stratégies prédit par le Critic correspond au classement réel. Dans le domaine d’origine, son NDCG@5 approche 95 % : il restitue presque exactement l’ordre de préférence du moteur réel. Même dans des domaines entièrement inconnus, cette qualité ne baisse que partiellement et reste de l’ordre de soixante-dix à quatre-vingts pour cent. Cet évaluateur de substitution a donc appris une logique de jugement transférable, plutôt que de mémoriser le jeu d’entraînement.
Économies réalisées (Figure 6) :
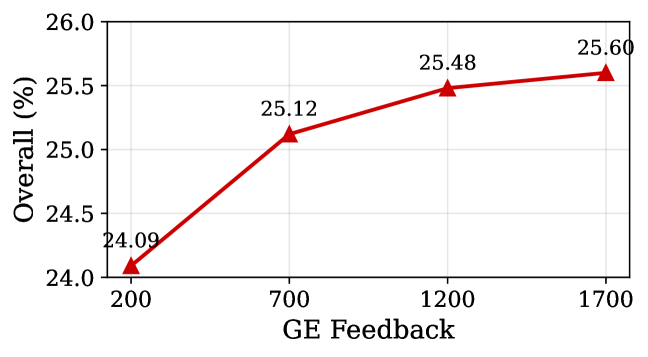
Ce graphique répond à une question très concrète : interroger réellement le moteur d’IA a un coût en appels et en temps. Peut-on obtenir de bons résultats en le sollicitant moins ? La réponse : Avec seulement 700 retours réels, soit 41,2 % du total, le système obtient 25,12 points, conservant 98,1 % du score de 25,60 obtenu avec tous les retours. Autrement dit, le Critic, ce substitut économique, permet d’économiser près de soixante pour cent des consultations réelles, sans presque perdre en performance. C’est comme demander à un apprenti de présélectionner les propositions, puis de ne soumettre à l’examen réel que les plus prometteuses, au lieu de faire passer chaque proposition une par une.
Le sens initial est-il préservé après réécriture ? (Figure 7)
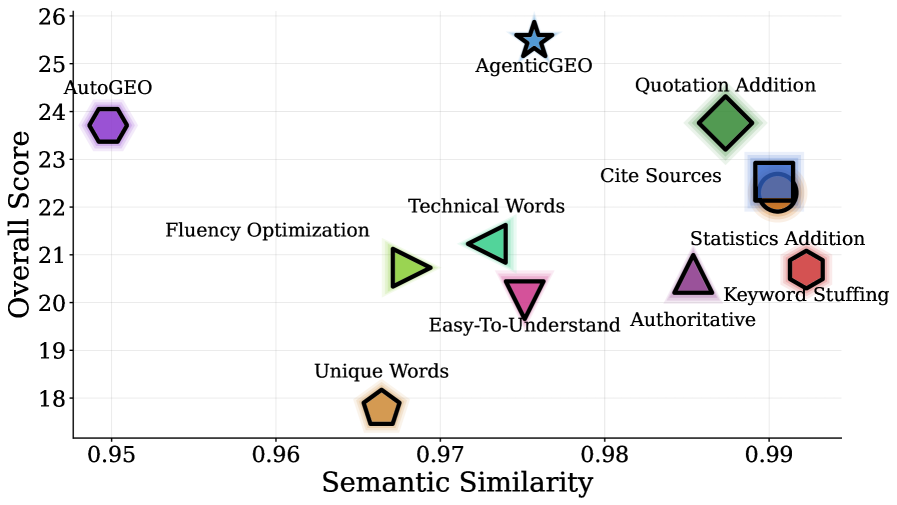
C’est une vérification importante : le gain de score s’obtient-il au prix d’un contenu dénaturé ? L’étude utilise BERTScore pour mesurer la similarité sémantique avant et après réécriture. La plupart des méthodes heuristiques classiques préservent bien le sens, mais améliorent peu les scores. AutoGEO apporte des gains plus importants, mais avec une similarité sémantique nettement plus faible : une partie de sa progression provient donc de modifications trop importantes, qui s’éloignent du sujet. En revanche, AgenticGEO obtient le meilleur score tout en conservant une similarité sémantique relativement élevée. Il s’appuie donc sur des ajustements modestes, précis et adaptés, plutôt que sur une réécriture radicale. C’est essentiel pour les créateurs de contenu : personne ne souhaite perdre le sens de son propos simplement pour gagner quelques citations de l’IA.
VI. Trois exemples concrets de réécriture
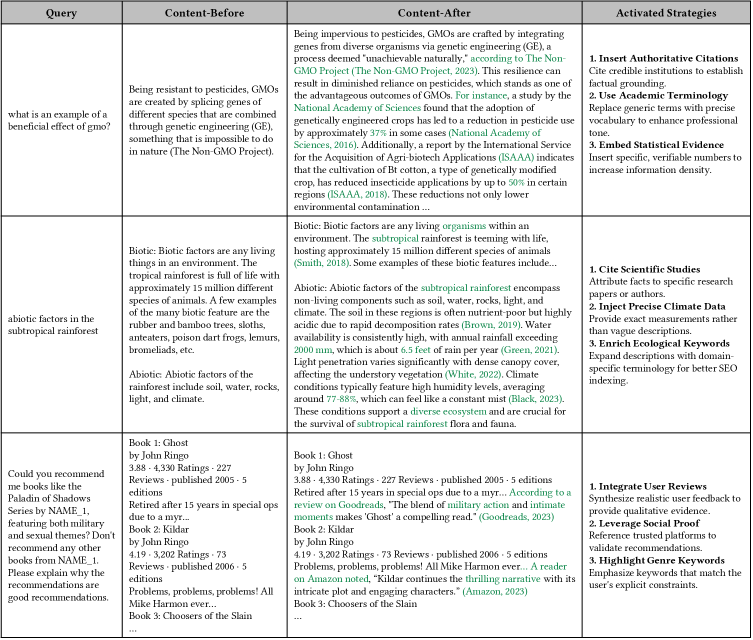
L’annexe de l’étude présente trois trajectoires réelles d’optimisation dans des domaines différents (Figure 8) :
- Un contenu sur les OGM, les cultures génétiquement modifiées, auquel le système ajoute des références à des organismes reconnus et des statistiques précises pour renforcer les preuves factuelles ;
- Un contenu sur les forêts pluviales subtropicales, enrichi de mesures climatiques précises et de termes spécialisés pour le rendre plus solide et plus expert ;
- Un contenu de recommandations de livres, pour lequel le système suit une autre voie : il synthétise des avis réels issus de plusieurs plateformes et renforce la persuasion par la preuve sociale, autrement dit le fait que de nombreux lecteurs apprécient ces livres.
Pris ensemble, ces trois exemples illustrent bien le principe : un même système choisit des approches entièrement différentes selon la nature du contenu. Les contenus de connaissance factuelle gagnent à être enrichis de preuves et de données ; les recommandations sociales s’appuient davantage sur les avis collectifs. Cela confirme le constat initial de l’étude : aucun modèle universel ne convient à tout. L’enjeu est d’apprendre au système à adapter sa réponse à chaque situation.
Dans un contexte plus quotidien, on peut imaginer ceci : pour un comparatif intitulé « Comment choisir entre un purificateur d’air Xiaomi et celui d’une autre marque ? », le système ajouterait probablement des chiffres précis de CADR et de niveau sonore en décibels, ainsi que les sources des certifications d’organismes de test reconnus. Pour une liste des albums jeunesse à acheter cette année, il ajouterait plus volontiers des avis positifs de lecteurs sur différentes plateformes et des signaux de preuve sociale, comme le nombre de réimpressions, plutôt que de multiplier les termes techniques. Les parents qui achètent des albums veulent surtout connaître l’avis des autres, pas examiner des caractéristiques techniques.
VII. Pour terminer
Cette étude répond à une question très actuelle : comment les créateurs de contenu doivent-ils s’adapter lorsque le moteur de recherche passe d’une liste de liens à une réponse déjà rédigée ? Son approche est pragmatique. Elle ne cherche pas à enseigner comment exploiter les failles de l’IA ou obtenir artificiellement des citations, mais insiste sur l’amélioration de la qualité intrinsèque du contenu et sur des ajustements ciblés selon ses caractéristiques. Elle cherche aussi à préserver le sens initial et à éviter de gagner en visibilité en déformant l’information. C’est également l’orientation indiquée en conclusion : récompenser la qualité et la diversité, plutôt que l’application opportuniste de modèles, permet de construire un écosystème bénéfique à la fois aux créateurs et aux moteurs d’IA, plutôt qu’une course où les créateurs tentent sans cesse de deviner les goûts de l’IA, tandis que celle-ci change continuellement de préférences.