コンテンツ制作者が AI の回答に引用されるには
キーワードの詰め込みは生成検索で効かなくなりつつあります。引用の可能性を本当に高めるのは、情報源、データ、引用文、明確な構成です。KDD 2024 の GEO 論文は、小規模サイトでもコンテンツの質によって AI の回答内で可視性を取り戻せる可能性を示しています。
トピック
4要旨
キーワードの詰め込みは生成検索で効かなくなりつつあります。引用の可能性を本当に高めるのは、情報源、データ、引用文、明確な構成です。KDD 2024 の GEO 論文は、小規模サイトでもコンテンツの質によって AI の回答内で可視性を取り戻せる可能性を示しています。
コンテンツ制作者が AI の回答に引用されるには
原論文:Pranjal Aggarwal、Vishvak Murahari、Tanmay Rajpurohit、Ashwin Kalyan、Karthik Narasimhan、Ameet Deshpande「GEO: Generative Engine Optimization」、KDD 2024。arXiv:2311.09735
この論文が解決しようとする問題
過去三十年間、検索エンジンは人々の情報の入手方法を変えてきました。しかし、その仕事は意外と単純です。キーワードを受け取り、関連するウェブページのリンクを返し、読むことも判断することもユーザーに任せます。大規模言語モデルの登場で状況は変わりました。BingChat、Google の SGE、Perplexity.ai などは、リンクを並べるだけでなく、複数のページを検索して情報を統合し、引用付きの自然言語の回答を生成します。論文では、このようなシステムをまとめて次のように呼びます。生成エンジン(Generative Engine、GE)。
生成エンジンは、ユーザーにも開発者にも利点があります。ユーザーはより速く答えを得られ、開発者は利用の定着とビジネス価値を高められます。しかし、一つの集団が取り残されています。ウェブサイトとコンテンツ制作者です。従来の検索エンジンなら、少なくともサイト自体へユーザーを送っていました。生成エンジンは回答の中で内容を処理し終えるため、ユーザーが元のリンクを開く必要がなくなり、サイトの露出や流入が減ります。さらに厄介なのは、生成エンジンがブラックボックスで、製品の更新も極めて速いことです。制作者は自分の内容がどのように検索され、要約され、引用されるかを知ることができず、露出を高めるためのツールもありませんでした。
そこで著者らが提案したのが、生成エンジン最適化(Generative Engine Optimization、GEO)です。ある意味で「次世代の SEO」と言える、コンテンツ制作者のために生成エンジン内の可視性を高める初の最適化フレームワークです。さまざまな手法を厳密に評価するため、一万件規模の検索クエリのベンチマークも構築しました。その名称が GEO-benchです。実験では、適切な最適化によって、生成エンジンの回答内でのコンテンツの可視性が最大 40%向上し、実際の製品である Perplexity.ai でも同様の改善を再現できました(最大 37%)。
生成エンジンはどのように動くのか
論文はまず、生成エンジンを形式的に定義します。生成エンジンはユーザーの質問 $q_u$ と、任意のパーソナライズ情報 $P_U$ を受け取り、自然言語の回答 $r$ を返します。
$$f_{GE} := (q_u, P_U) \rightarrow r$$
内部は二つの部分で構成されています。
- 複数の生成モデル $G=\{G_1, G_2, ..., G_n\}$ は、それぞれクエリの書き換え、要約の生成、最終回答の作成など、異なるサブタスクを担当します。
- 単一の検索エンジン $SE$ は、クエリに基づいて候補となる情報源の集合 $S=\{s_1, s_2, ..., s_m\}$ を返します。
論文の典型的な処理手順(原論文の Figure 2 に対応し、当時の BingChat の設計に近い)は、三つの段階に分かれます。
- 質問の書き換え:書き換えモデル $G_{qr}$ が、ユーザーの元の質問を、検索しやすい複数のサブクエリに分解します。
- 検索と要約:サブクエリを検索エンジンへ送り、順位づけされた情報源のページを取得します。要約モデル $G_{sum}$ が、それぞれの情報源の要約を生成します。
- 回答の生成:回答生成モデル $G_{resp}$ がすべての要約を統合し、筋の通った回答を作成して、文ごとに出典を示します。
大規模言語モデルにはハルシネーションがあるため、引用の仕組みが非常に重要です。理想的には、回答のすべての文に、それを裏づける引用が必要です(引用再現率が高いこと)。同時に、各引用は、付された文を実際に裏づけるものでなければなりません(引用適合率が高いこと)。論文は主に、一つの質問に一つの回答を返す単一ターンの生成エンジンを対象にしていますが、付録では複数ターンの会話への拡張も論じています。
「可視性」を新しく定義する
SEO の基本的な考え方は単純です。検索結果におけるページの平均順位が高いほど、露出と流入が増えます。しかし、この考え方は生成エンジンにはそのまま適用できません。生成エンジンは順位順のリンク一覧を見せるのではなく、複数の情報源を一つの文章に織り込みます。引用の位置や長さ、見せ方もさまざまです。
そこで論文は、生成エンジン専用の「露出度(impression)」指標を提案しました。設計時に重視した原則は三つです。制作者に実際の意味があり、解釈でき、一般の制作者にも理解しやすいこと。具体的には、次の指標があります。
1. 単語数の割合(Word Count):ある情報源が引用された文の総単語数が、回答全体の総単語数に占める割合です。一つの文に複数の情報源が付いている場合は、単語数を均等に分けます。考え方は単純で、引用される文章が長いほど、その情報源の存在感が強くなるというものです。
2. 位置調整済み単語数(Position-Adjusted Word Count):単語数の割合をもとに、回答の前方にある引用文に重みを付け、後ろにいくほど重みを指数関数的に減らします。多くのクリック率研究では、検索結果への注目度は順位に応じてべき乗則で低下すると示されています。その考え方を、生成エンジンの回答内の文の順序にも適用しています。
3. 主観的印象(Subjective Impression):前の二つは客観的な計数ですが、露出には単語数だけでは測れない面もあります。質問との関連性、回答全体への貢献、内容の独自性、読者から見た目立ちやすさ、クリックされる可能性、提示情報の多様性などです。論文では、GPT による採点を用いる有力な LLM 自動評価手法である G-Eval を使い、七つの下位項目を個別に評価します。その後、平均と分散を位置調整済み単語数と比較できるよう正規化します。
この指標体系は「順位を見る」よりはるかに複雑ですが、生成エンジンの回答の実際の構造に即しています。原論文の Figure 3 は、従来の検索結果ページの線形なランキング一覧と、長さも位置も異なる引用が文章に織り込まれた生成エンジンの回答を、図で比較しています。この違いこそが、可視性の指標を設計し直す必要を生んだのです。
実践できる九つの GEO 最適化戦略
測り方を定めたら、次は改善方法です。論文は大規模言語モデルでサイトの原文を書き換え、9 種類の戦略を提案・検証しました。各戦略は、元のページ内容 $W$ を最適化後の $W’$ へ変換する関数 $f: W \rightarrow W’$ と捉えられます。
|
戦略 |
方法 |
|---|---|
|
権威性の強化(Authoritative) |
説得力と権威性のある文体に変える |
|
統計データの追加(Statistics Addition) |
定性的な説明を、できるだけ数値データに置き換える |
|
キーワードの詰め込み(Keyword Stuffing) |
従来型の SEO のように、質問に関連するキーワードを多く入れる |
|
出典の引用(Cite Sources) |
信頼できる情報源の引用を加える |
|
引用文の追加(Quotation Addition) |
権威ある人物・機関の発言を直接引用する |
|
わかりやすさの向上(Easy-to-Understand) |
言葉を平易にし、理解のハードルを下げる |
|
流暢さの改善(Fluency Optimization) |
文章の流れを滑らかにする |
|
独自の語彙(Unique Words) |
あまり使われない独特の表現を加える |
|
専門用語(Technical Terms) |
専門的・技術的な語彙を加える |
キーワードの詰め込み、出典の引用、引用文の追加の三つは、新しい内容の補足が必要です。ほかの六つは情報量を増やさず、見せ方だけを改善します。公平に比較するため、各質問で候補となる情報源のサイトを無作為に一つ選び、九つの戦略をそれぞれ適用して、露出の変化を観察します。
評価方法:GEO-bench
生成エンジン向けの公開された検索クエリデータセットは、それまで存在しませんでした。そこで著者らが独自に構築したのが、GEO-benchです。9 種類の情報源から集めた 1 万件の質問を含み、学習・検証・テスト用に 8000/1000/1000 件ずつ分けています。
- MS MARCO、ORCAS-I、Natural Questions:Bing や Google の実際のユーザーの質問に由来する、検索エンジン研究で定番の三つのデータセットです。
- AllSouls(オックスフォード大学 All Souls College の論述試験の問題)、LIMA(推論と創作の能力を必要とする難しい質問)、Davinci-Debate(議論を求める質問)、Perplexity.ai Discover(プラットフォームで人気のトレンド質問)、ELI5(「五歳の子どもに説明するように」平易な答えを求める複雑な質問)、GPT-4 が生成した質問(科学、歴史など多分野をカバーし、ナビゲーショナル、トランザクショナルなど、異なる検索意図も含む)。
全体の質問分布は、できるだけ実際の利用に近づけています。情報収集型が 80%、取引型と案内型が各 10% です。各質問には、Google 検索上位 5 件の情報源のページから抽出・整形したテキストが付いています。さらに GPT-4 で、難易度、質問の性質、分野、具体的な主題、機微性、ユーザーの意図、回答の種類という 7 種類のラベルを付け、適合率と再現率を人手で確認しました。GEO-bench は芸術、健康、ゲームなど 25 分野、9 種類のデータソース、7 種類の分類軸をカバーし、規模と多様性の両面で充実した生成エンジン専用ベンチマークとなっています。
実験で使った生成エンジンの試作版は、先行研究(Liu et al., 2023)の二段階の設計を踏襲しています。まず Google で上位 5 件の情報源を取得し、次に gpt-3.5-turbo で統一したプロンプトを用いて回答を生成します。完全なプロンプトは原論文の付録にあり、中心となる指示は「与えられた検索結果だけをもとに答え、各文の直後にインライン引用を付ける」ことです。ランダム性を抑えるため、各質問を温度 0.7 で 5 回サンプリングし、平均を取っています。
主な結果:本当に有効な戦略は何か
次の表は論文の主結果表(原文の Table 1)で、9 種類の戦略について、二つの指標群の絶対スコアを「最適化なし」の基準と比較しています。すべての引用の露出度の合計が 1 となるよう正規化し、読みやすくするため定数を掛けています。値が大きいほど、露出度が高いことを意味します。
|
手法 |
位置調整済み単語数(総合) |
主観的印象(平均) |
|---|---|---|
|
最適化なし(基準) |
19.3 |
19.3 |
|
キーワードの詰め込み |
17.7 |
20.2 |
|
独自の語彙 |
20.5 |
20.4 |
|
わかりやすさの向上 |
22.0 |
20.5 |
|
権威性の強化 |
21.3 |
22.9 |
|
専門用語 |
22.7 |
21.4 |
|
流暢さの改善 |
24.7 |
21.9 |
|
出典の引用 |
24.6 |
21.9 |
|
引用文の追加 |
27.2 |
24.7 |
|
統計データの追加 |
25.2 |
23.7 |
明確に見て取れる結論があります。
- 従来の SEO の手法は、ここではほとんど効果がありません。キーワードの詰め込みは改善につながらず、位置調整済み単語数では最適化しない場合より低くなりました。生成エンジンのモデルは、キーワードの一致ではなく意味によって文章を理解するため、単純な詰め込みは低品質なコンテンツと認識されやすいことを示しています。
- 最も効果的だったのは「引用文の追加」「統計データの追加」「出典の引用」の三つです。基準に対する改善幅は、位置調整済み単語数で 30%~40%、主観的印象で 15%~30% でした。三つに共通するのは、文体を飾るのではなく、内容自体の信頼性と情報密度を高めることです。権威ある出典、直接の引用文、具体的な数値を一つ補うだけなら、低コストで大きな成果が期待できます。
- やや意外なことに、文体だけを改善する「流暢さの向上」と「平易化」でも 15%~30% の向上が見られました。生成エンジンは「何を述べているか」だけでなく、「いかにうまく伝えているか」も重視していることがうかがえます。
- 一方、文体をより権威的で説得力のあるものにする Authoritative の改善幅は大きくありませんでした。論文は、生成エンジンが語調だけの説得にある程度頑健であることを示すと解釈しています。制作者は表現を飾るより、内容自体の信頼性に力を注ぐべきです。
さらに詳しい分析
分野によって有効な戦略は異なる
実務の SEO に万能策がないのと同様、GEO にも万能策はありません。論文は GEO-bench のラベル別に分析し(原文の Table 3)、次の傾向を見つけました。
|
戦略 |
最も適した分野(効果順) |
|---|---|
|
権威性の強化 |
議論を求める質問 > 歴史 > 科学 |
|
流暢さの改善 |
ビジネス > 科学 > 健康 |
|
出典の引用 |
記述を求める質問 > 事実に関する質問 > 法律・行政 |
|
引用文の追加 |
人と社会 > 説明を求める質問 > 歴史 |
|
統計データの追加 |
法律・行政 > 議論 > 意見を求める質問 |
この傾向は直感にも合います。議論を求める問いには、説得力のある論述が向いています。事実に関する問いには、検証可能性を裏づける引用が必要です。法律や行政のようにデータや条文を重視する分野では、統計数値は抽象的な説明より説得力があります。個人の体験や歴史的な出来事には、直接の引用がリアリティと厚みを加えます。これは、論文が繰り返し強調する次の考え方とも一致します。制作者は「万能戦略」を盲目的に当てはめず、自分のサイトが扱う分野に応じて戦略を選ぶべきです。
全員が GEO を使うようになったら、最も得をするのは誰か
誰もが思う疑問があります。すべての制作者が GEO を始めたら、効果が相殺され、無駄な努力になるのでしょうか。著者らは、一つの質問に対するすべての候補情報源を同時に最適化し、検索順位ごとのサイトが得る相対的な改善幅を調べました(原文の Table 2)。
|
手法 |
第 1 位 |
第 2 位 |
第 3 位 |
第 4 位 |
第 5 位 |
|---|---|---|---|---|---|
|
権威性の強化 |
-6.0% |
+4.1% |
-0.6% |
+12.6% |
+6.1% |
|
流暢さの改善 |
-2.0% |
+5.2% |
+3.6% |
-4.4% |
+2.2% |
|
出典の引用 |
-30.3% |
+2.5% |
+20.4% |
+15.5% |
+115.1% |
|
引用文の追加 |
-22.9% |
-7.0% |
+3.5% |
+25.1% |
+99.7% |
|
統計データの追加 |
-20.6% |
-3.9% |
+8.1% |
+10.0% |
+97.9% |
結果は明確でした。順位が低いサイトほど、GEO から大きな恩恵を受けました。一方、首位のサイトは露出を下げる可能性がありました。例えば、出典の引用戦略では、もともと第五位だったサイトの可視性が 115% 増加し、首位のサイトは平均 30.3% 減少しました。理由は理解しやすいでしょう。従来の検索順位は、被リンク数やドメインの評価など、強者ほど有利になる要因に大きく左右されます。中小の制作者が大手の蓄積した資源に対抗するのは困難です。しかし生成エンジンは内容そのものを理解し、情報を組み立てます。引用、データ、引用文といった内容の質が直接露出につながり、構造的な障壁に縛られにくくなります。つまり、GEO は、大規模サイトと小規模な制作者のデジタル格差を縮める手段になる可能性があります。個人事業者や独立したコンテンツ制作者にとって、非常に前向きな兆しです。
戦略を組み合わせると、さらに効果が高まる
実際の制作者は、一つの手法だけを使うわけではありません。論文は、効果の高かった四つの戦略、出典の引用、流暢さの改善、統計データの追加、引用文の追加を二つずつ組み合わせて検証しました(原文 Figure 4 のヒートマップ)。その結果、「流暢さの改善」と「統計データの追加」が最良の組み合わせでした。どちらか一方だけの場合より、5.5% 以上高い成果となりました。さらに興味深いのは、出典の引用は単独では四つの中で最下位で、引用文の追加より約 8% 低かったにもかかわらず、ほかと組み合わせた平均改善率は 31.4% に達したことです。四つの中で組み合わせによる相乗効果が最も顕著でした。ここから、制作者への示唆が得られます。戦略の中には、組み合わせて初めて価値を十分に発揮するものがあります。単独での成績だけを見て、その価値を否定してはいけません。
次の表は、二つずつ組み合わせた際の改善率を再現しています。データは原文 Figure 4 のヒートマップから取得し、行と列の交点は、二つの戦略を組み合わせたときの基準に対する平均改善率を示します。
|
|
流暢さ |
統計データ |
出典の引用 |
引用文の追加 |
行平均 |
|---|---|---|---|---|---|
|
流暢さ |
22.4% |
35.8% |
34.4% |
33.0% |
31.4% |
|
統計データ |
35.8% |
27.0% |
30.3% |
35.4% |
32.1% |
|
出典の引用 |
34.4% |
30.3% |
19.1% |
20.1% |
26.0% |
|
引用文の追加 |
33.0% |
35.4% |
20.1% |
30.3% |
29.7% |
対角線上の値、例えば「流暢さ+流暢さ」の 22.4% は、同じ戦略を二回使った比較基準です。対角線以外は、異なる二つの戦略を組み合わせた効果です。「行平均」は原文のヒートマップの一番右の列に対応します。出典の引用は単独では最下位ですが、ほかと組み合わせると、平均改善率は三番目の高さになることがわかります。
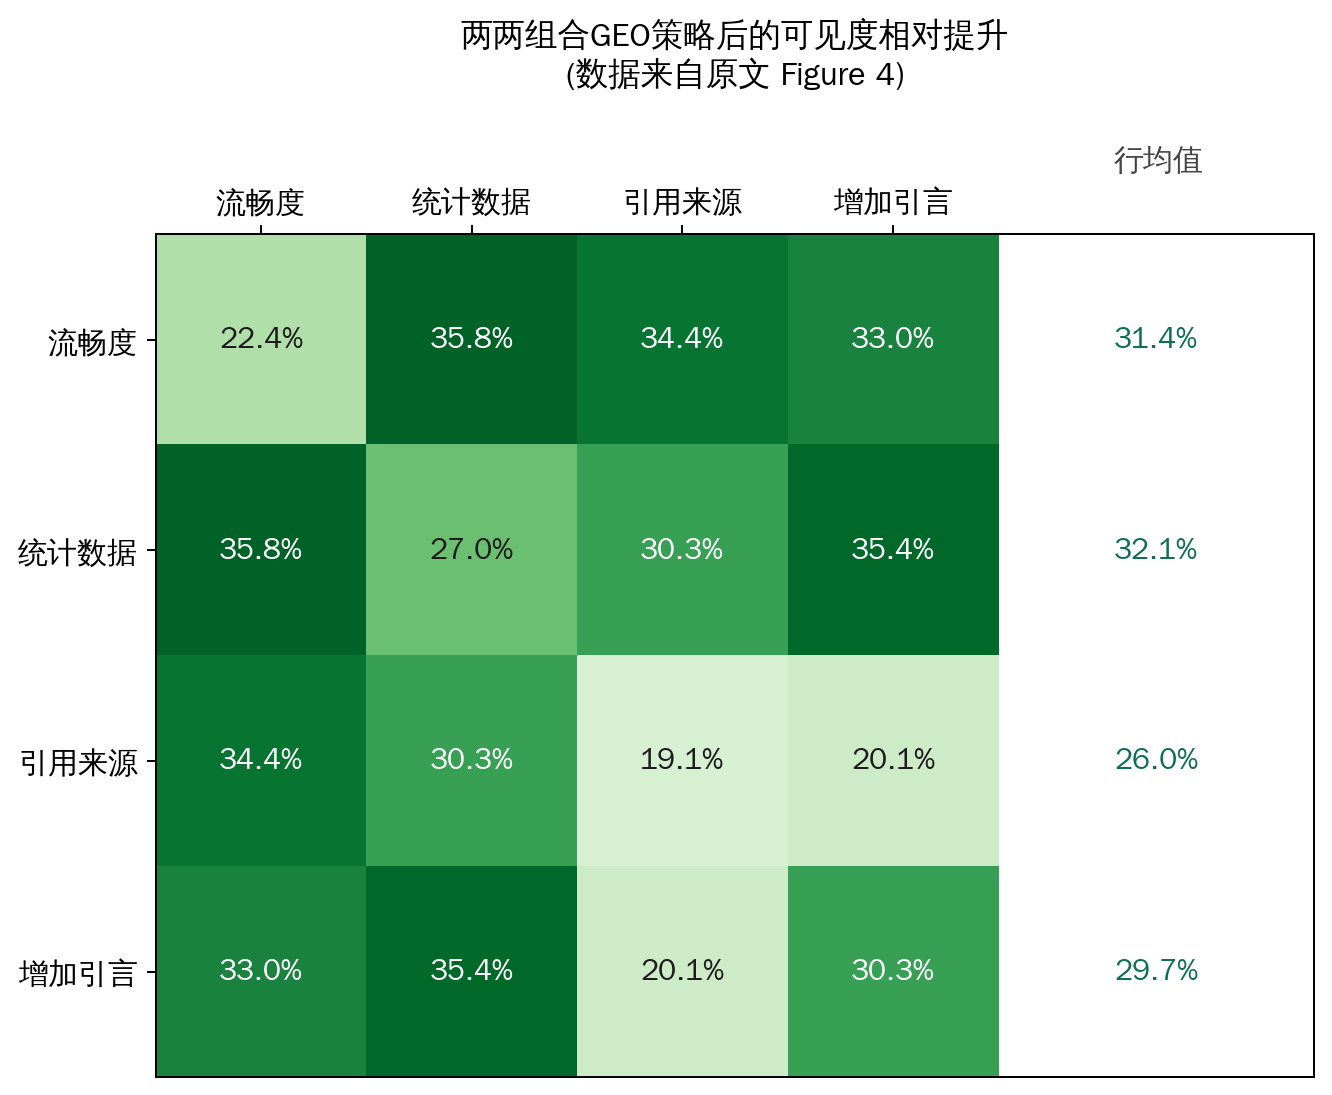
上の図は原文 Figure 4 のデータをもとに描き直したものです。色が濃いほど、組み合わせによる改善幅が大きいことを示します。
実際の最適化例
論文には、わかりやすい最適化の実例があります(原文 Table 4)。出典の引用、統計データの追加、権威性の強化に対応する三例に共通するのは、わずかな修正で、可視性が大きく向上したことです。スイスの一人当たりのチョコレート消費量に関する文に調査機関の出典を補っただけで、可視性は 132.4% 向上しました。ロボットによる人手の代替についての文に具体的な増加率を加えると 65.5%、あるチームの戦績についての淡々とした記述を、既存の実績を強調する断定的な文章に変えると 89.1% 向上しました。こうした例は、GEO の最適化では多くの場合、新しいコンテンツをつくる必要がなく、既存の内容に出典や数値を一つ加えたり、語調の確信度を調整したりするだけでよいことを示しています。一般の制作者にも取り組みやすい方法です。
実験室の外へ:Perplexity.ai での実証
研究結果が実験室の中だけで通用するものではないと確かめるため、著者らは同じ方法を、多くのユーザーが利用する実際の生成エンジン製品 Perplexity.ai で検証しました。Perplexity.ai は情報源の URL を直接指定できなかったため、元の文章をファイルとしてアップロードし、その内容だけに基づいて回答するよう制限しました。200 件の質問を抽出してテストしています(原文 Table 5)。
|
手法 |
位置調整済み単語数 |
主観的印象 |
|---|---|---|
|
最適化なし(基準) |
24.1 |
24.7 |
|
キーワードの詰め込み |
21.9 |
28.1 |
|
引用文の追加 |
29.1 |
32.1 |
|
統計データの追加 |
26.2 |
33.9 |
結果は、実験環境で得られたものとよく一致しました。キーワードの詰め込みは、位置調整済み単語数で引き続きマイナスでした(基準より約 10% 低下)。一方、引用文や統計データの追加といった、内容の信頼性を高める戦略は引き続き優れた成果を示し、それぞれ約 22% と 37% の改善をもたらしました。意味は三つあります。生成エンジン専用の最適化が必要だと再確認できたこと、特定の実験用エンジンに依存せず製品をまたいで応用できると示されたこと、そして制作者がこれらの簡単な戦略を実際の製品にも使い、実益を得られるとわかったことです。
より広い研究の流れの中での位置づけ
論文は、先行する三つの研究群との違いを整理しています。
- 証拠に基づく回答生成:WebGPT のように、モデルをウェブ環境で操作させ、情報源に裏づけられた回答を生成する研究や、検索結果に基づく回答生成手法があります。GEO はそれらのシステム上で統一した評価基準を提供します。また、敵対的な文章で LLM の推薦を操作し、商品の露出を高める近年の研究とは異なり、GEO が提案するのは、非敵対的で、あらゆるウェブサイトの内容に適用できる最適化戦略です。
- 検索拡張生成:RAG や REALM などは主に、言語モデルが知識を記憶しきれない問題を扱います。一方、生成エンジンはより広い作業を担います。回答を生成し、全体を通じて出典を示すだけでなく、質問の書き換えや情報源の選別なども含み、単なる検索にはとどまりません。
- 従来の SEO:過去 25 年ほどの SEO 研究は、内容と体験を改善するサイト内最適化と、被リンクやドメインの権威性を高めるサイト外最適化に分かれます。しかし、これは検索エンジンがキーワードを照合するという前提に立っています。生成モデルが中心となり、キーワード照合に限定されない生成エンジンには、そのまま適用できません。そこに GEO の意義があります。
結論と限界
まとめると、この論文は三つのことを行いました。生成エンジンを形式的に定義し、生成エンジン向けの、制作者のための初の最適化フレームワーク GEO を提案しました(可視性の指標体系と 9 種類の具体的な戦略を含む)。さらに、評価ベンチマーク GEO-bench を構築し、オープンソースで公開しました。主な発見は、出典、引用文、統計データといった信頼性を高める修正により、生成エンジンの回答でのサイトの可視性が最大 40% 向上することです。適した戦略は分野によって異なり、複数の戦略の併用は通常、単独より優れています。また、順位の低い小規模サイトほど恩恵が大きく、個人の制作者や中小サイトには前向きな結果です。
著者らは限界も率直に示しています。第一に、生成エンジン自体が急速に進化しており、SEO が過去に経験したように、GEO も継続的な更新が必要になりそうだということです。第二に、GEO-bench は実際の質問分布に近づけていますが、質問の性質は時間とともに変わるため、基準も更新し続ける必要があります。第三に、検索ランキングのアルゴリズムがブラックボックスであるため、GEO の修正が従来の検索順位に逆に影響するかは検証していません。著者らは、修正が主に本文に限られ、ドメインや被リンクなどの要因には触れないため、影響は限定的だと考えています。最後に、モデルのコンテキスト長が伸びれば、生成エンジンが扱える情報源の数は増え、検索順位そのものの重要性がさらに下がる可能性があります。全体として、この論文は新しい研究分野の基礎を築くものです。フレームワーク、指標、ベンチマークを示し、後続の研究者が共通の基準で研究を進められるようにしています。