Cómo pueden los creadores de contenidos ser citados en respuestas de IA
La acumulación de palabras clave empieza a perder eficacia en la búsqueda generativa. Las fuentes, los datos, las citas y una estructura clara son lo que realmente aumenta las posibilidades de ser citado. El artículo GEO de KDD 2024 demuestra que incluso los sitios pequeños pueden recuperar visibilidad en las respuestas de la IA mediante la calidad de sus contenidos.
Temas
4Resumen
La acumulación de palabras clave empieza a perder eficacia en la búsqueda generativa. Las fuentes, los datos, las citas y una estructura clara son lo que realmente aumenta las posibilidades de ser citado. El artículo GEO de KDD 2024 demuestra que incluso los sitios pequeños pueden recuperar visibilidad en las respuestas de la IA mediante la calidad de sus contenidos.
Cómo pueden los creadores de contenidos ser citados en respuestas de IA
Artículo original: Pranjal Aggarwal, Vishvak Murahari, Tanmay Rajpurohit, Ashwin Kalyan, Karthik Narasimhan y Ameet Deshpande, «GEO: Generative Engine Optimization», KDD 2024. arXiv:2311.09735
¿Qué problema intenta resolver este artículo?
Durante los últimos treinta años, los buscadores han transformado nuestra forma de acceder a la información. Sin embargo, su funcionamiento era bastante rudimentario: introducir palabras clave, recibir una lista de enlaces relevantes y dejar al usuario toda la lectura y la evaluación. La aparición de los grandes modelos de lenguaje cambia la situación. Productos como BingChat, SGE de Google y Perplexity.ai ya no se limitan a listar enlaces: consultan varias páginas, sintetizan información y generan una respuesta en lenguaje natural con citas. El artículo agrupa estos sistemas bajo el término motor generativo (Generative Engine, GE).
Los motores generativos benefician a usuarios y desarrolladores: los primeros obtienen respuestas más rápido y los segundos logran mayor fidelización y valor comercial. Pero un grupo queda al margen: los sitios web y los creadores de contenido. Los buscadores tradicionales al menos enviaban usuarios a los sitios. Los motores generativos incorporan directamente el contenido en su respuesta, por lo que el usuario puede no necesitar abrir el enlace original. Así disminuyen la exposición y el tráfico de los sitios. Además, estos motores son cajas negras y sus productos evolucionan muy rápido. Los creadores no saben cómo se recupera, resume y cita su contenido, y tampoco disponen de herramientas para mejorar su exposición.
Por eso, los autores proponen la optimización para motores generativos (Generative Engine Optimization, GEO) —en cierto modo, la siguiente generación del SEO—, el primer marco de optimización dirigido a creadores de contenido y centrado específicamente en su visibilidad en estos motores. Para evaluar con rigor las distintas técnicas, también construyeron un conjunto de referencia del orden de diez mil consultas, GEO-bench. Los experimentos muestran que una optimización adecuada puede aumentar la visibilidad de un contenido en las respuestas de un motor generativo hasta en un 40%, y que la mejora también puede reproducirse en el producto real Perplexity.ai, con un máximo del 37 %.
¿Cómo funciona realmente un motor generativo?
El artículo comienza con una definición formal. Un motor generativo recibe una consulta del usuario $q_u$, junto con información opcional de personalización $P_U$, y produce una respuesta en lenguaje natural $r$:
$$f_{GE} := (q_u, P_U) \rightarrow r$$
Se compone de dos elementos:
- Un conjunto de modelos generativos $G=\{G_1, G_2, ..., G_n\}$, cada uno encargado de una subtarea, como reformular consultas, generar resúmenes o redactar la respuesta final;
- Un motor de búsqueda $SE$, que devuelve un conjunto de fuentes candidatas $S=\{s_1, s_2, ..., s_m\}$ a partir de la consulta.
El proceso típico descrito en el artículo, presentado en la Figura 2 y cercano al diseño de BingChat de entonces, tiene tres pasos:
- Reformulación de la consulta: un modelo de reformulación $G_{qr}$ divide la pregunta original en varias subconsultas más adecuadas para la recuperación;
- Recuperación y resumen: esas subconsultas se envían al buscador, que devuelve páginas fuente ordenadas. Después, un modelo de resumen $G_{sum}$ genera un resumen de cada fuente;
- Generación de la respuesta: el modelo $G_{resp}$ combina todos los resúmenes en una respuesta coherente e indica las fuentes citadas en cada frase.
Como los grandes modelos pueden producir alucinaciones, el mecanismo de citas es esencial. Idealmente, en la respuesta, cada frase debería estar respaldada por una cita, con una alta exhaustividad de citas, y cada cita debería respaldar realmente la frase a la que está asociada, con una alta precisión de citas. El artículo se centra en motores generativos de un solo turno, con una pregunta y una respuesta, aunque en el apéndice también aborda la posibilidad de extenderlos a conversaciones de varios turnos.
Redefinir la visibilidad
El principio central del SEO es sencillo: cuanto mejor es la posición media de una página en los resultados, mayor es su exposición y su tráfico. Esta lógica no funciona en los motores generativos: no presentan una lista ordenada de enlaces, sino que combinan la información de varias fuentes en un mismo texto, donde las citas pueden aparecer en cualquier lugar, ocupar extensiones distintas y presentarse de formas muy variadas.
Por eso el artículo propone un sistema de métricas de exposición, o «impression», diseñado para motores generativos según tres principios: tener utilidad real para los creadores, ser interpretables y resultar comprensibles para creadores no especializados. Las métricas son las siguientes:
1. Proporción de palabras (Word Count): el número total de palabras de las frases que citan una fuente dividido por el total de palabras de la respuesta. Si una frase cita varias fuentes, sus palabras se reparten por igual entre ellas. La intuición es sencilla: cuanto más texto citado ocupa una fuente, mayor es su presencia en la respuesta.
2. Recuento de palabras ajustado por posición (Position-Adjusted Word Count): a partir de la proporción de palabras, esta métrica asigna un peso mayor a las frases citadas situadas al principio de la respuesta, con un peso que disminuye exponencialmente según la posición. Muchos estudios sobre tasas de clic muestran que la atención a los resultados disminuye con su posición según una ley de potencias. Esa misma lógica se aplica aquí al orden de las frases en la respuesta generativa.
3. Impresión subjetiva (Subjective Impression): las dos primeras métricas se basan en recuentos objetivos. Pero la exposición también tiene dimensiones que el número de palabras no capta: relevancia de la cita para la pregunta, contribución a la respuesta completa, originalidad, notoriedad percibida, probabilidad de clic y diversidad de la información, entre otras. El artículo utiliza G-Eval, un método de evaluación automática con LLM basado en puntuaciones de GPT y reconocido en ese momento por su rendimiento, para puntuar siete subdimensiones. Después normaliza los resultados para que su media y varianza sean comparables a las del recuento de palabras ajustado por posición.
Este sistema es mucho más complejo que observar posiciones, pero refleja mejor la estructura real de las respuestas generativas. La Figura 3 del artículo compara visualmente una página tradicional de resultados, organizada como una lista lineal, con una respuesta generativa que intercala citas de distinta extensión y ubicación. Esa diferencia hace necesario rediseñar las métricas de visibilidad.
Nueve estrategias GEO aplicables
Una vez definido cómo medir la visibilidad, queda determinar cómo mejorarla. Los autores utilizan un gran modelo de lenguaje para reescribir el contenido original de los sitios y proponen y evalúan 9 estrategias. Cada una corresponde a una función $f: W \rightarrow W’$, que transforma el contenido original $W$ en contenido optimizado $W’$:
|
Estrategia |
Enfoque |
|---|---|
|
Refuerzo de autoridad (Authoritative) |
Adoptar un estilo más persuasivo y con mayor autoridad |
|
Añadir estadísticas (Statistics Addition) |
Sustituir, cuando sea posible, las descripciones cualitativas por datos cuantitativos |
|
Acumulación de palabras clave (Keyword Stuffing) |
Insertar más palabras clave relacionadas con la consulta, como en el SEO tradicional |
|
Citar fuentes (Cite Sources) |
Añadir referencias de fuentes fiables |
|
Añadir citas textuales (Quotation Addition) |
Añadir citas textuales de personas u organismos autorizados |
|
Simplificación (Easy-to-Understand) |
Simplificar el lenguaje para facilitar la comprensión |
|
Mejora de la fluidez (Fluency Optimization) |
Mejorar la fluidez de la redacción |
|
Vocabulario distintivo (Unique Words) |
Añadir expresiones poco habituales u originales |
|
Terminología especializada (Technical Terms) |
Añadir vocabulario especializado o técnico |
La acumulación de palabras clave, la cita de fuentes y la incorporación de citas textuales requieren añadir elementos nuevos. Las otras seis estrategias solo mejoran la presentación, sin aportar información adicional. Para comparar de forma equitativa, los autores seleccionan al azar un sitio fuente candidato para cada consulta, aplican por separado las nueve estrategias y observan el cambio en la exposición.
Cómo evaluar: GEO-bench
Como no existía ningún conjunto público de consultas destinado a motores generativos, los autores crearon uno: GEO-bench, que contiene 10.000 consultas de 9 fuentes distintas, distribuidas en 8000/1000/1000 para entrenamiento, validación y prueba:
- MS MARCO, ORCAS-I y Natural Questions: consultas reales de usuarios de Bing y Google, tres recursos clásicos de la investigación sobre buscadores;
- AllSouls (preguntas de ensayo de All Souls College, de la Universidad de Oxford), LIMA (preguntas difíciles que requieren razonamiento y creatividad), Davinci-Debate (preguntas de debate), Perplexity.ai Discover (consultas populares y tendencias de la plataforma), ELI5 (preguntas complejas que deben responderse con la sencillez de una explicación para un niño de cinco años), Consultas generadas por GPT-4 (que abarcan ciencias, historia y otros ámbitos, así como distintas intenciones, entre ellas navegación y transacción).
La distribución busca acercarse al uso real: el 80 % de las consultas son informativas, y las transaccionales y de navegación representan un 10 % cada una. Cada consulta incluye el texto depurado de las primeras 5 páginas fuente devueltas por Google. Además, los autores utilizan GPT-4 para asignar 7 categorías de etiquetas —dificultad, naturaleza de la consulta, dominio, tema concreto, sensibilidad, intención y tipo de respuesta— y verifican manualmente su precisión y exhaustividad. GEO-bench abarca así 25 dominios, como arte, salud y juegos, 9 fuentes de datos y 7 dimensiones de clasificación. Es un conjunto de referencia específico para motores generativos de escala y diversidad considerables en ese momento.
El prototipo de motor generativo utilizado en el experimento retoma una arquitectura de dos pasos de trabajos anteriores (Liu et al., 2023): primero, recuperar con Google las 5 primeras fuentes; después, utilizar gpt-3.5-turbo para generar la respuesta con una plantilla de instrucciones común. El apéndice incluye el prompt completo, cuyas exigencias principales son responder solo a partir de los resultados facilitados y añadir una cita integrada después de cada frase. Para reducir la aleatoriedad, cada consulta se muestrea 5 veces con una temperatura de 0,7 y se promedian los resultados.
Resultados principales: ¿qué estrategias funcionan realmente?
La siguiente tabla reproduce la tabla principal del artículo, la Tabla 1. Presenta las puntuaciones absolutas de las 9 estrategias en las dos familias de métricas, frente a la referencia sin optimización. Los valores se normalizan para que la exposición total de todas las citas sume 1 y después se multiplican por una constante para facilitar la lectura. Cuanto mayor es el valor, mayor es la exposición.
|
Método |
Palabras ajustadas por posición (puntuación total) |
Impresión subjetiva (media) |
|---|---|---|
|
Sin optimización (referencia) |
19.3 |
19.3 |
|
Acumulación de palabras clave |
17.7 |
20.2 |
|
Vocabulario distintivo |
20.5 |
20.4 |
|
Simplificación |
22.0 |
20.5 |
|
Refuerzo de autoridad |
21.3 |
22.9 |
|
Terminología especializada |
22.7 |
21.4 |
|
Mejora de la fluidez |
24.7 |
21.9 |
|
Fuentes citadas |
24.6 |
21.9 |
|
Añadir citas textuales |
27.2 |
24.7 |
|
Añadir estadísticas |
25.2 |
23.7 |
Se desprenden varias conclusiones claras:
- las fórmulas del SEO tradicional funcionan poco en este contexto. La acumulación de palabras clave no mejora los resultados e incluso queda por debajo de la ausencia de optimización en palabras ajustadas por posición. Esto indica que los modelos de los motores generativos comprenden el texto a partir de su significado, no de una simple coincidencia de palabras clave. Una acumulación artificial puede percibirse como señal de baja calidad.
- Las tres mejores estrategias son añadir citas textuales, añadir estadísticas y citar fuentes, con mejoras del 30 % al 40 % en palabras ajustadas por posición y del 15 % al 30 % en impresión subjetiva respecto de la referencia. Su rasgo común es reforzar la credibilidad y la densidad informativa del contenido, en lugar de adornar el estilo. Añadir una fuente autorizada, una cita textual o una cifra concreta requiere poca inversión, pero puede aportar una mejora considerable.
- Resulta algo sorprendente que mejorar únicamente el estilo mediante la fluidez o la simplificación también aporte mejoras del 15 % al 30 %. Los motores generativos tienen en cuenta no solo qué se dice, sino también cómo se expresa.
- En cambio, adoptar simplemente un estilo más contundente y persuasivo, la estrategia Authoritative, no aporta una mejora significativa. Los autores lo interpretan como cierta resistencia de los motores generativos a la persuasión basada solo en el tono. Por ello, los creadores deberían priorizar la credibilidad del contenido sobre el envoltorio retórico.
Análisis complementarios
Cada ámbito requiere estrategias distintas
En la práctica, ninguna técnica SEO sirve para todos los casos, y lo mismo ocurre con el GEO. El análisis por etiquetas de GEO-bench, presentado en la Tabla 3, muestra lo siguiente:
|
Estrategia |
Ámbitos más adecuados, por orden de eficacia |
|---|---|
|
Refuerzo de autoridad |
Preguntas de debate > Historia > Ciencias |
|
Mejora de la fluidez |
Negocios > Ciencias > Salud |
|
Fuentes citadas |
Preguntas declarativas > Preguntas factuales > Derecho y gobierno |
|
Añadir citas textuales |
Personas y sociedad > Preguntas explicativas > Historia |
|
Añadir estadísticas |
Derecho y gobierno > Debate > Preguntas de opinión |
Estas tendencias resultan intuitivas: los debates favorecen una argumentación persuasiva; las preguntas factuales necesitan referencias que permitan verificarlas; en derecho y gobierno, donde importan los datos y las normas, las estadísticas convencen más que las descripciones abstractas; y en relatos personales o históricos, las citas textuales aportan autenticidad y profundidad. Esto coincide con una idea reiterada en el artículo: los creadores deben elegir según el ámbito de contenido de su sitio, en lugar de aplicar a ciegas una estrategia universal.
Si todo el mundo adopta el GEO, ¿quién se beneficia más?
Surge una pregunta natural: si todos los creadores utilizan GEO, ¿no terminarán anulándose sus esfuerzos? Los autores realizaron un experimento que consistía en optimizar todas las fuentes candidatas de una misma consulta simultáneamente, y medir las mejoras relativas de los sitios según su posición inicial, como muestra la Tabla 2:
|
Método |
Posición 1 |
Posición 2 |
Posición 3 |
Posición 4 |
Posición 5 |
|---|---|---|---|---|---|
|
Refuerzo de autoridad |
-6.0% |
+4.1% |
-0.6% |
+12.6% |
+6.1% |
|
Mejora de la fluidez |
-2.0% |
+5.2% |
+3.6% |
-4.4% |
+2.2% |
|
Fuentes citadas |
-30.3% |
+2.5% |
+20.4% |
+15.5% |
+115.1% |
|
Añadir citas textuales |
-22.9% |
-7.0% |
+3.5% |
+25.1% |
+99.7% |
|
Añadir estadísticas |
-20.6% |
-3.9% |
+8.1% |
+10.0% |
+97.9% |
El resultado es muy claro: cuanto más baja es la posición de un sitio, más se beneficia del GEO. El sitio que ocupa el primer lugar incluso puede perder terreno: con la estrategia de citar fuentes, la visibilidad del sitio inicialmente quinto aumenta un 115 %, mientras que la del primero cae un 30,3 % de media. La explicación es sencilla. La clasificación tradicional depende mucho del número de enlaces entrantes y de la autoridad del dominio, factores en los que las ventajas tienden a reforzarse. Los creadores pequeños y medianos difícilmente compiten con los recursos acumulados por grandes organizaciones. Los motores generativos, en cambio, comprenden y organizan la información a partir del propio contenido: las fuentes, los datos y las citas pueden traducirse directamente en visibilidad, con menos dependencia de esas barreras estructurales. En otras palabras, el GEO puede contribuir a reducir la brecha digital entre los grandes sitios y los pequeños creadores —una señal muy positiva para profesionales autónomos y creadores independientes.
Combinar estrategias mejora los resultados
En la práctica, los creadores no se limitan a un solo método. Los autores seleccionaron las cuatro mejores estrategias —fuentes, fluidez, estadísticas y citas textuales— y las probaron por parejas, como muestra el mapa de calor de la Figura 4. Los resultados indican que mejorar la fluidez y añadir estadísticas es la mejor combinación y supera en más de un 5,5 % a cada estrategia utilizada por separado. Más interesante aún: citar fuentes ocupa el último lugar entre las cuatro cuando se utiliza solo, alrededor de un 8 % por debajo de añadir citas textuales. Sin embargo, combinado con otras estrategias alcanza una mejora media del 31,4 %, el beneficio por combinación más marcado. Esto indica a los creadores que algunas estrategias solo despliegan todo su valor al combinarse, y no deben descartarse únicamente por su rendimiento individual.
La siguiente tabla recoge las mejoras de las combinaciones por parejas a partir del mapa de calor de la Figura 4. Cada intersección muestra la mejora media al combinar ambas estrategias respecto de la referencia.
|
|
Fluidez |
Datos estadísticos |
Fuentes citadas |
Añadir citas textuales |
Media de la fila |
|---|---|---|---|---|---|
|
Fluidez |
22.4% |
35.8% |
34.4% |
33.0% |
31.4% |
|
Datos estadísticos |
35.8% |
27.0% |
30.3% |
35.4% |
32.1% |
|
Fuentes citadas |
34.4% |
30.3% |
19.1% |
20.1% |
26.0% |
|
Añadir citas textuales |
33.0% |
35.4% |
20.1% |
30.3% |
29.7% |
Los valores de la diagonal, como el 22,4 % de «fluidez + fluidez», corresponden a aplicar dos veces la misma estrategia y sirven de referencia. Las demás celdas miden la combinación de dos estrategias distintas. La columna de media reproduce la situada a la derecha del mapa de calor original: muestra que citar fuentes, último en uso individual, alcanza la tercera mejor mejora media al combinarse con otros métodos.
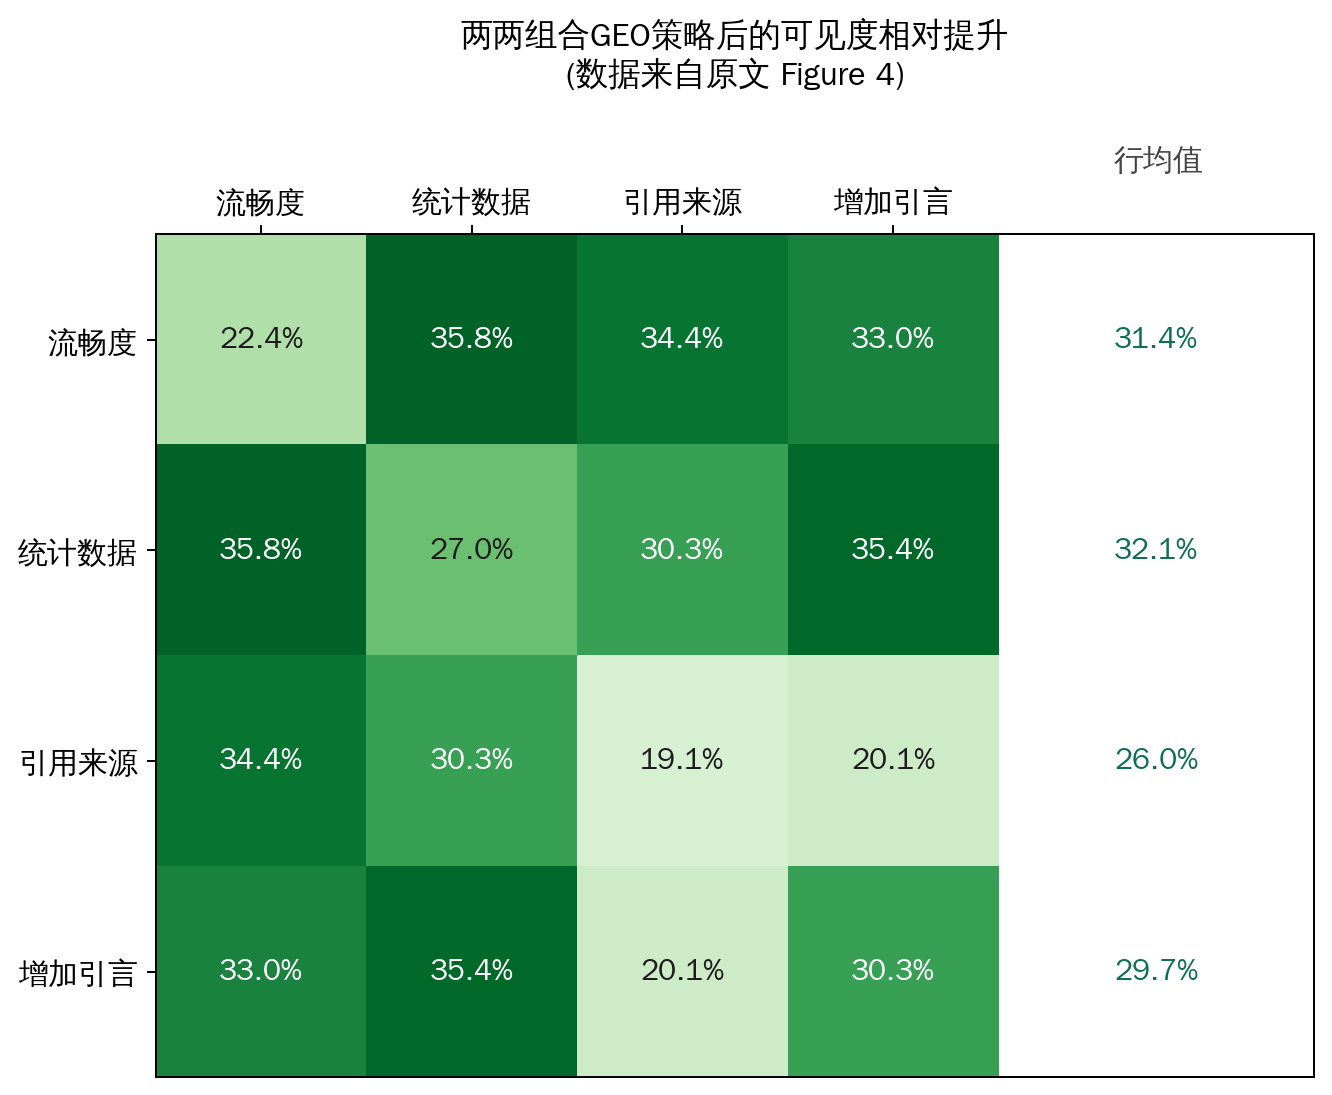
Este gráfico se ha redibujado a partir de los datos de la Figura 4 del artículo. Cuanto más oscuro es el color, mayor es la mejora de la combinación.
¿Cómo son los casos concretos?
El artículo presenta varios ejemplos ilustrativos en la Tabla 4. Los tres casos corresponden a citar fuentes, añadir estadísticas y reforzar la autoridad. Comparten una característica: cambios muy pequeños producen mejoras de visibilidad considerables. Añadir una referencia a una institución de investigación a una afirmación sobre el consumo de chocolate por habitante en Suiza aumenta la visibilidad un 132,4 %. Completar una frase sobre robots que sustituyen trabajo humano con un porcentaje concreto de crecimiento aporta un 65,5 %. Reformular una descripción del historial de un equipo deportivo de forma más contundente y destacando sus logros produce un 89,1 %. Estos ejemplos muestran que la optimización GEO a menudo no exige crear contenido nuevo, sino añadir una fuente, una cifra o ajustar el grado de seguridad de un texto existente. Por tanto, resulta muy accesible para los creadores corrientes.
Fuera del laboratorio: validación en Perplexity.ai
Para mostrar que los resultados van más allá de un prototipo de laboratorio, los autores aplicaron los mismos métodos a un motor generativo realmente disponible y con muchos usuarios, Perplexity.ai. Como Perplexity.ai no permitía especificar directamente las URL de las fuentes, se proporcionaron los textos mediante archivos y se restringió la respuesta a esos documentos. Se evaluó una muestra de 200 consultas, recogida en la Tabla 5.
|
Método |
Palabras ajustadas por posición |
Impresión subjetiva |
|---|---|---|
|
Sin optimización (referencia) |
24.1 |
24.7 |
|
Acumulación de palabras clave |
21.9 |
28.1 |
|
Añadir citas textuales |
29.1 |
32.1 |
|
Añadir estadísticas |
26.2 |
33.9 |
Los resultados coinciden ampliamente con los del laboratorio: la acumulación de palabras clave sigue siendo negativa en palabras ajustadas por posición con alrededor de un 10 % menos que la referencia, mientras que la incorporación de citas textuales y la adición de estadísticas siguen destacando entre las estrategias que refuerzan la credibilidad del contenido, con mejoras aproximadas del 22 % y del 37 %, respectivamente. El resultado tiene tres implicaciones: confirma la necesidad de métodos diseñados para motores generativos; muestra su capacidad de generalizarse entre productos, sin depender de un motor experimental concreto; e indica que los creadores pueden aplicar directamente estas estrategias sencillas para obtener beneficios reales en productos disponibles.
Situar esta investigación en un contexto más amplio
El artículo distingue su aportación de tres categorías de trabajos anteriores:
- Generación de respuestas respaldadas por pruebas: sistemas como WebGPT entrenan modelos para navegar por la web y generar respuestas respaldadas por fuentes, y otros métodos producen respuestas a partir de resultados de búsqueda. El GEO añade a estos sistemas un marco de evaluación unificado. Además, a diferencia de un trabajo reciente sobre cómo manipular recomendaciones de LLM con textos adversarios para aumentar la exposición de productos, propone estrategias de optimización no adversarias aplicables al contenido de cualquier sitio.
- Generación aumentada por recuperación: trabajos como RAG y REALM abordan principalmente las limitaciones de los modelos de lenguaje para memorizar conocimientos. Los motores generativos tienen un alcance mayor: deben producir respuestas e indicar las fuentes a lo largo de todo el proceso, además de realizar subtareas como reformular consultas y seleccionar fuentes. No se limitan a recuperar información.
- SEO tradicional: los estudios de SEO de los últimos 25 años se dividen entre optimización dentro del sitio, para mejorar contenido y experiencia, y fuera del sitio, para crear enlaces entrantes y aumentar la autoridad del dominio. Pero esta lógica supone que el buscador relaciona palabras clave. Resulta poco aplicable en un entorno guiado por modelos generativos que va más allá de esa coincidencia: esa es precisamente la razón de ser del GEO.
Conclusión y limitaciones
En resumen, este artículo realiza tres aportaciones: una definición formal de los motores generativos, el primer marco GEO de optimización para creadores dirigido a motores generativos —con métricas de visibilidad y 9 estrategias concretas—, así como la creación y publicación abierta del conjunto de referencia GEO-bench. Su conclusión principal es que los cambios que refuerzan la credibilidad —fuentes, citas textuales y estadísticas— pueden aumentar hasta un 40 % la visibilidad de un sitio en las respuestas generativas. Las estrategias adecuadas varían según el ámbito; combinarlas suele funcionar mejor que utilizarlas por separado; y los sitios pequeños con posiciones bajas se benefician especialmente. Es una señal positiva para los creadores independientes y los sitios pequeños y medianos.
Los autores también señalan varias limitaciones. Primero, los motores generativos evolucionan rápidamente: como ha ocurrido con el SEO, los métodos GEO probablemente necesitarán ajustes continuos. Segundo, aunque GEO-bench intenta representar las consultas reales, su naturaleza cambia con el tiempo y el conjunto debe actualizarse. Tercero, como los algoritmos de clasificación son opacos, el artículo no evalúa si los cambios GEO afectan a las posiciones en la búsqueda tradicional. Los autores consideran que el efecto debería ser limitado, porque los cambios se centran en el texto y no afectan al dominio ni a los enlaces entrantes. Por último, el aumento de la longitud de contexto permitirá utilizar más fuentes, lo que podría reducir aún más la importancia de la posición en los resultados. En conjunto, el artículo sienta las bases de un campo nuevo: su marco, sus métricas y su conjunto de referencia buscan permitir que futuras investigaciones avancen sobre una base común.