Comment les créateurs de contenu peuvent être cités dans les réponses de l’IA
Dans la recherche générative, l’accumulation de mots-clés commence à perdre son efficacité. Ce sont les sources, les données, les citations et une structure claire qui augmentent réellement les chances d’être cité. L’étude GEO présentée à KDD 2024 montre que même les petits sites peuvent regagner de la visibilité dans les réponses de l’IA grâce à la qualité de leur contenu.
Thèmes
4Résumé
Dans la recherche générative, l’accumulation de mots-clés commence à perdre son efficacité. Ce sont les sources, les données, les citations et une structure claire qui augmentent réellement les chances d’être cité. L’étude GEO présentée à KDD 2024 montre que même les petits sites peuvent regagner de la visibilité dans les réponses de l’IA grâce à la qualité de leur contenu.
Comment les créateurs de contenu peuvent être cités dans les réponses de l’IA
Article original : Pranjal Aggarwal, Vishvak Murahari, Tanmay Rajpurohit, Ashwin Kalyan, Karthik Narasimhan et Ameet Deshpande, « GEO : Generative Engine Optimization », KDD 2024. arXiv:2311.09735
Quel problème cette étude cherche-t-elle à résoudre ?
Au cours des trente dernières années, les moteurs de recherche ont transformé notre accès à l’information. Leur fonctionnement restait pourtant assez rudimentaire : saisir des mots-clés, obtenir une série de liens pertinents, puis laisser à l’utilisateur tout le travail de lecture et de jugement. L’arrivée des grands modèles de langage change la donne. Des produits comme BingChat, SGE de Google et Perplexity.ai ne se contentent plus de lister des liens : ils consultent plusieurs pages, synthétisent les informations et produisent une réponse en langage naturel avec des citations. L’étude regroupe ces systèmes sous le terme de moteur génératif (Generative Engine, GE).
Les moteurs génératifs profitent aux utilisateurs et aux développeurs : les premiers obtiennent plus vite leurs réponses, tandis que les seconds renforcent la fidélisation et la valeur commerciale. Mais un groupe reste à l’écart : les sites Web et les créateurs de contenu. Les moteurs traditionnels dirigeaient au moins les utilisateurs vers les sites. Les moteurs génératifs assimilent directement le contenu dans leur réponse, si bien que l’utilisateur n’a parfois aucune raison d’ouvrir le lien original. La visibilité et le trafic des sites diminuent alors. Plus difficile encore : ces moteurs sont des boîtes noires et leurs produits évoluent très vite. Les créateurs ignorent comment leurs contenus sont récupérés, résumés et cités, et ne disposent d’aucun outil pour améliorer leur visibilité.
Les auteurs proposent donc l’optimisation pour les moteurs génératifs (Generative Engine Optimization, GEO) — en quelque sorte, la génération suivante du SEO —, premier cadre d’optimisation destiné aux créateurs de contenu et spécifiquement consacré à leur visibilité dans ces moteurs. Pour évaluer rigoureusement les différentes méthodes, ils ont aussi construit un jeu de référence de l’ordre de dix mille requêtes, GEO-bench. Les expériences montrent qu’une optimisation adaptée peut augmenter la visibilité d’un contenu dans les réponses d’un moteur génératif d’au maximum 40 %, et que ce gain peut aussi être reproduit sur le produit réel Perplexity.ai, avec une hausse maximale de 37 %.
Comment fonctionne réellement un moteur génératif ?
L’étude commence par une définition formelle. Un moteur génératif reçoit une requête utilisateur $q_u$, ainsi que d’éventuelles informations de personnalisation $P_U$, et produit une réponse en langage naturel $r$ :
$$f_{GE} := (q_u, P_U) \rightarrow r$$
Il se compose de deux éléments :
- Un ensemble de modèles génératifs $G=\{G_1, G_2, ..., G_n\}$, chacun chargé d’une sous-tâche, comme reformuler la requête, produire des résumés ou rédiger la réponse finale ;
- Un moteur de recherche $SE$, qui renvoie, à partir de la requête, un ensemble de sources candidates $S=\{s_1, s_2, ..., s_m\}$.
Le déroulement type décrit dans l’étude, présenté en Figure 2 et proche de la conception de BingChat à l’époque, comporte trois étapes :
- Reformulation de la requête : un modèle de reformulation $G_{qr}$ décompose la question initiale en plusieurs sous-requêtes mieux adaptées à la recherche ;
- Recherche et synthèse : ces sous-requêtes sont envoyées au moteur de recherche, qui renvoie des pages sources classées. Un modèle de synthèse $G_{sum}$ produit ensuite un résumé de chaque source ;
- Génération de la réponse : le modèle $G_{resp}$ combine tous les résumés en une réponse cohérente et indique les sources citées au niveau de chaque phrase.
Les grands modèles pouvant produire des hallucinations, le mécanisme de citation est essentiel. Idéalement, dans la réponse, chaque phrase devrait être étayée par une citation, pour un rappel élevé des citations, et chaque citation devrait réellement étayer la phrase à laquelle elle est associée, pour une précision élevée des citations. L’étude se concentre sur les moteurs génératifs à un seul tour, avec une question et une réponse. Elle aborde néanmoins en annexe les possibilités d’extension aux conversations à plusieurs tours.
Redéfinir la visibilité
Le principe central du SEO est simple : plus le classement moyen d’une page est élevé dans les résultats, plus elle gagne en visibilité et en trafic. Ce raisonnement ne s’applique pas aux moteurs génératifs : ils ne présentent pas une liste ordonnée de liens, mais combinent les informations de plusieurs sources dans un même texte, où les citations peuvent apparaître à n’importe quel endroit, occuper des espaces variables et prendre des formes très différentes.
L’étude propose donc un ensemble d’indicateurs d’exposition, ou « impression », conçus pour les moteurs génératifs selon trois principes : être utiles concrètement aux créateurs, interprétables et accessibles aux créateurs non spécialistes. Ces indicateurs sont les suivants :
1. Part des mots (Word Count) : le nombre total de mots des phrases citant une source, rapporté au nombre de mots de toute la réponse. Si une phrase cite plusieurs sources, ses mots sont répartis également entre elles. L’intuition est simple : plus une source occupe de texte cité, plus sa présence dans la réponse est forte.
2. Nombre de mots pondéré par la position (Position-Adjusted Word Count) : à partir de la part des mots, cet indicateur attribue un poids plus élevé aux phrases citées situées au début de la réponse, avec une pondération qui décroît exponentiellement selon la position. De nombreuses études sur le taux de clic montrent en effet que l’attention portée aux résultats diminue avec leur rang selon une loi de puissance. La même logique est ici appliquée à l’ordre des phrases dans la réponse générative.
3. Impression subjective (Subjective Impression) : les deux premiers indicateurs reposent sur des comptages objectifs. Mais l’exposition comporte aussi des dimensions que le nombre de mots ne mesure pas : pertinence de la citation pour la question, contribution à la réponse globale, originalité, saillance perçue, probabilité de clic et diversité des informations présentées, notamment. L’étude utilise G-Eval, une méthode d’évaluation automatique par LLM fondée sur la notation GPT et reconnue à ce stade pour ses performances, afin de noter sept sous-dimensions. Les résultats sont ensuite normalisés pour obtenir une moyenne et une variance comparables à celles du nombre de mots pondéré par la position.
Ce dispositif est bien plus complexe qu’un simple classement, mais reflète mieux la structure réelle des réponses génératives. La Figure 3 de l’article compare visuellement une page de résultats traditionnelle, organisée en liste linéaire, et une réponse générative, où des citations de longueurs et de positions différentes sont insérées dans le texte. C’est cette différence qui impose de redéfinir les indicateurs de visibilité.
Neuf stratégies GEO applicables
Après avoir défini comment mesurer la visibilité, reste à savoir comment l’améliorer. Les auteurs utilisent un grand modèle de langage pour réécrire les contenus originaux des sites et proposent 9 stratégies qu’ils évaluent. Chacune correspond à une fonction $f : W \rightarrow W’$, transformant le contenu original $W$ en contenu optimisé $W’$ :
|
Stratégie |
Approche |
|---|---|
|
Renforcement de l’autorité (Authoritative) |
Adopter un style plus persuasif et faisant davantage autorité |
|
Ajout de statistiques (Statistics Addition) |
Remplacer autant que possible les descriptions qualitatives par des données chiffrées |
|
Accumulation de mots-clés (Keyword Stuffing) |
Insérer davantage de mots-clés liés à la requête, comme en SEO traditionnel |
|
Citation de sources (Cite Sources) |
Ajouter des références issues de sources fiables |
|
Ajout de citations (Quotation Addition) |
Ajouter des citations directes de personnes ou d’organismes faisant autorité |
|
Simplification (Easy-to-Understand) |
Simplifier le langage pour faciliter la compréhension |
|
Amélioration de la fluidité (Fluency Optimization) |
Améliorer la fluidité rédactionnelle du texte |
|
Vocabulaire distinctif (Unique Words) |
Ajouter des formulations rares ou originales |
|
Terminologie spécialisée (Technical Terms) |
Ajouter des termes spécialisés ou techniques |
L’accumulation de mots-clés, la citation de sources et l’ajout de citations textuelles nécessitent de nouveaux éléments. Les six autres stratégies améliorent uniquement la présentation, sans apport d’information supplémentaire. Pour assurer une comparaison équitable, les auteurs sélectionnent aléatoirement un site source candidat pour chaque requête, lui appliquent séparément les neuf stratégies, puis observent l’évolution de l’exposition.
Comment évaluer : GEO-bench
Il n’existait auparavant aucun jeu public de requêtes destiné aux moteurs génératifs. Les auteurs en ont donc créé un : GEO-bench, qui comprend 10 000 requêtes issues de 9 sources différentes, réparties en 8000/1000/1000 pour l’entraînement, la validation et le test :
- MS MARCO, ORCAS-I et Natural Questions : de véritables requêtes d’utilisateurs de Bing et de Google, trois références classiques de la recherche sur les moteurs ;
- AllSouls (questions de dissertation d’All Souls College, à l’université d’Oxford), LIMA (questions difficiles nécessitant raisonnement et créativité), Davinci-Debate (questions de débat), Perplexity.ai Discover (requêtes populaires et tendances de la plateforme), ELI5 (questions complexes auxquelles il faut répondre aussi simplement que si l’on s’adressait à un enfant de cinq ans), Requêtes générées par GPT-4 (couvrant notamment les sciences et l’histoire, ainsi que différentes intentions, dont la navigation et la transaction).
La répartition cherche à rester proche des usages réels : 80 % des requêtes sont informationnelles, les requêtes transactionnelles et navigationnelles représentant chacune 10 %. Chaque requête est accompagnée du texte nettoyé des 5 premières pages sources renvoyées par Google. Les auteurs utilisent également GPT-4 pour attribuer 7 catégories d’annotations — difficulté, nature de la requête, domaine, sujet précis, sensibilité, intention et type de réponse —, puis vérifient manuellement la précision et le rappel. GEO-bench couvre ainsi 25 domaines, dont les arts, la santé et les jeux, 9 sources de données et 7 dimensions de classification. Il constitue un jeu de référence spécialement consacré aux moteurs génératifs, d’une ampleur et d’une diversité remarquables à ce stade.
Le prototype de moteur génératif utilisé dans l’expérience reprend une architecture en deux étapes issue de travaux antérieurs (Liu et al., 2023) : d’abord, récupérer avec Google les 5 premières sources ; ensuite, utiliser gpt-3.5-turbo pour générer la réponse avec un modèle de consigne commun. L’annexe donne le prompt complet, dont les exigences centrales sont de répondre uniquement à partir des résultats fournis et d’ajouter une citation intégrée après chaque phrase. Pour réduire l’aléa, chaque requête est échantillonnée 5 fois à une température de 0,7, puis les résultats sont moyennés.
Principaux résultats : quelles stratégies fonctionnent vraiment ?
Le tableau ci-dessous reprend le tableau principal de l’étude, le Tableau 1. Il présente les scores absolus des 9 stratégies sur les deux familles d’indicateurs, par comparaison à la référence sans optimisation. Les valeurs ont été normalisées pour que l’exposition totale de toutes les citations soit égale à 1, puis multipliées par une constante pour faciliter la lecture. Plus le score est élevé, plus l’exposition est importante.
|
Méthode |
Mots pondérés par la position (score total) |
Impression subjective (moyenne) |
|---|---|---|
|
Sans optimisation (référence) |
19.3 |
19.3 |
|
Accumulation de mots-clés |
17.7 |
20.2 |
|
Vocabulaire distinctif |
20.5 |
20.4 |
|
Simplification |
22.0 |
20.5 |
|
Renforcement de l’autorité |
21.3 |
22.9 |
|
Terminologie spécialisée |
22.7 |
21.4 |
|
Amélioration de la fluidité |
24.7 |
21.9 |
|
Sources citées |
24.6 |
21.9 |
|
Ajout de citations textuelles |
27.2 |
24.7 |
|
Ajout de statistiques |
25.2 |
23.7 |
Plusieurs conclusions se dégagent nettement :
- les recettes du SEO traditionnel fonctionnent peu dans ce contexte. L’accumulation de mots-clés n’améliore pas les résultats et produit même un score inférieur à l’absence d’optimisation pour les mots pondérés par la position. Cela indique que les modèles des moteurs génératifs comprennent le texte à partir de son sens, et non d’une simple correspondance de mots-clés. Une accumulation artificielle peut être perçue comme un signe de faible qualité.
- Les trois meilleures stratégies sont l’ajout de citations textuelles, l’ajout de statistiques et la citation de sources, avec des gains de 30 % à 40 % sur les mots pondérés par la position et de 15 % à 30 % sur l’impression subjective, par rapport à la référence. Leur point commun est de renforcer la crédibilité et la densité d’information du contenu, plutôt que d’en habiller le style. Ajouter une source reconnue, une citation directe ou un chiffre précis coûte peu, mais peut apporter un gain important.
- Plus surprenant, la seule amélioration du style par la fluidité ou la simplification apporte aussi des gains de 15 % à 30 %. Les moteurs génératifs se soucient donc non seulement du fond, mais aussi de la qualité de l’expression.
- À l’inverse, adopter simplement un style plus affirmé et persuasif, la stratégie Authoritative, n’apporte pas de gain significatif. Les auteurs y voient une certaine résistance des moteurs génératifs à la persuasion purement tonale. Les créateurs devraient donc privilégier la crédibilité du fond plutôt que l’habillage rhétorique.
Analyses complémentaires
À chaque domaine ses stratégies
Dans la pratique, aucune méthode SEO ne convient à tous les cas, et il en va de même pour le GEO. L’analyse par catégories de GEO-bench, présentée dans le Tableau 3, montre les correspondances suivantes :
|
Stratégie |
Domaines les plus adaptés, par ordre d’efficacité |
|---|---|
|
Renforcement de l’autorité |
Questions de débat > Histoire > Sciences |
|
Amélioration de la fluidité |
Commerce > Sciences > Santé |
|
Sources citées |
Questions déclaratives > Questions factuelles > Droit et administration |
|
Ajout de citations textuelles |
Personnes et société > Questions explicatives > Histoire |
|
Ajout de statistiques |
Droit et administration > Débat > Questions d’opinion |
Ces tendances sont intuitives : les débats favorisent naturellement une argumentation persuasive ; les questions factuelles ont besoin de références pour être vérifiables ; dans le droit et l’administration, où données et textes réglementaires comptent, les statistiques convainquent davantage que les formulations abstraites ; et dans les récits personnels ou historiques, les citations directes apportent authenticité et profondeur. Cela rejoint une idée récurrente de l’étude : les créateurs doivent choisir selon le domaine de leur site, plutôt que d’appliquer aveuglément une stratégie universelle.
Si tout le monde adopte le GEO, qui en profite le plus ?
Une question vient naturellement : si tous les créateurs utilisent le GEO, leurs efforts ne finiront-ils pas par s’annuler ? Les auteurs ont donc réalisé une expérience consistant à optimiser toutes les sources candidates d’une même requête simultanément, puis à mesurer les gains relatifs obtenus par les sites selon leur position initiale, comme le montre le Tableau 2 :
|
Méthode |
Position 1 |
Position 2 |
Position 3 |
Position 4 |
Position 5 |
|---|---|---|---|---|---|
|
Renforcement de l’autorité |
-6.0 % |
+4.1 % |
-0.6 % |
+12.6 % |
+6.1 % |
|
Amélioration de la fluidité |
-2.0 % |
+5.2 % |
+3.6 % |
-4.4 % |
+2.2 % |
|
Sources citées |
-30.3 % |
+2.5 % |
+20.4 % |
+15.5 % |
+115.1 % |
|
Ajout de citations textuelles |
-22.9 % |
-7.0 % |
+3.5 % |
+25.1 % |
+99.7 % |
|
Ajout de statistiques |
-20.6 % |
-3.9 % |
+8.1 % |
+10.0 % |
+97.9 % |
Le résultat est très net : plus un site est bas dans le classement, plus il bénéficie du GEO. Le premier site peut même perdre du terrain : avec la stratégie de citation de sources, la visibilité du site initialement cinquième augmente de 115 %, tandis que celle du premier recule en moyenne de 30,3 %. L’explication est simple. Le classement traditionnel dépend fortement du nombre de liens entrants et de l’autorité du domaine, des facteurs où les avantages tendent à se renforcer eux-mêmes. Les petits et moyens créateurs rivalisent difficilement avec les ressources accumulées par les grandes organisations. Les moteurs génératifs, eux, comprennent et organisent l’information à partir du contenu lui-même : les références, données et citations peuvent directement se traduire en visibilité, avec moins de dépendance à ces obstacles structurels. Autrement dit, le GEO pourrait contribuer à réduire la fracture numérique entre les grands sites et les petits créateurs — un signal très positif pour les indépendants et les créateurs de contenu autonomes.
Combiner les stratégies améliore les résultats
En pratique, les créateurs ne se limitent pas à une seule méthode. Les auteurs ont retenu les quatre meilleures stratégies — citation de sources, fluidité, statistiques et citations textuelles — et les ont testées par paires, comme l’illustre la carte thermique de la Figure 4. Le résultat montre que l’amélioration de la fluidité associée à l’ajout de statistiques est la meilleure combinaison, avec un gain supérieur de plus de 5,5 % à celui de chaque stratégie utilisée seule. Plus intéressant encore : la citation de sources arrive dernière des quatre lorsqu’elle est utilisée seule, environ 8 % derrière l’ajout de citations textuelles. Mais associée aux autres stratégies, elle atteint un gain moyen de 31,4 %, soit le bénéfice de combinaison le plus marqué. Cela indique aux créateurs que certaines stratégies ne révèlent tout leur intérêt qu’en combinaison, et qu’il ne faut pas les écarter sur la seule base de leur performance isolée.
Le tableau ci-dessous reprend les gains des combinaisons par paires, d’après la carte thermique de la Figure 4. Chaque intersection indique le gain moyen de la combinaison des deux stratégies par rapport à la référence.
|
|
Fluidité |
Données statistiques |
Sources citées |
Ajout de citations textuelles |
Moyenne de la ligne |
|---|---|---|---|---|---|
|
Fluidité |
22.4 % |
35.8 % |
34.4 % |
33.0 % |
31.4 % |
|
Données statistiques |
35.8 % |
27.0 % |
30.3 % |
35.4 % |
32.1 % |
|
Sources citées |
34.4 % |
30.3 % |
19.1 % |
20.1 % |
26.0 % |
|
Ajout de citations textuelles |
33.0 % |
35.4 % |
20.1 % |
30.3 % |
29.7 % |
Les valeurs de la diagonale, comme les 22,4 % de « fluidité + fluidité », correspondent à l’application répétée d’une même stratégie et servent de référence de comparaison. Les autres cases mesurent l’association de deux stratégies différentes. La colonne de moyenne reprend celle située à droite de la carte thermique originale : elle montre clairement que la citation de sources, dernière en usage isolé, atteint la troisième meilleure amélioration moyenne lorsqu’elle est combinée aux autres méthodes.
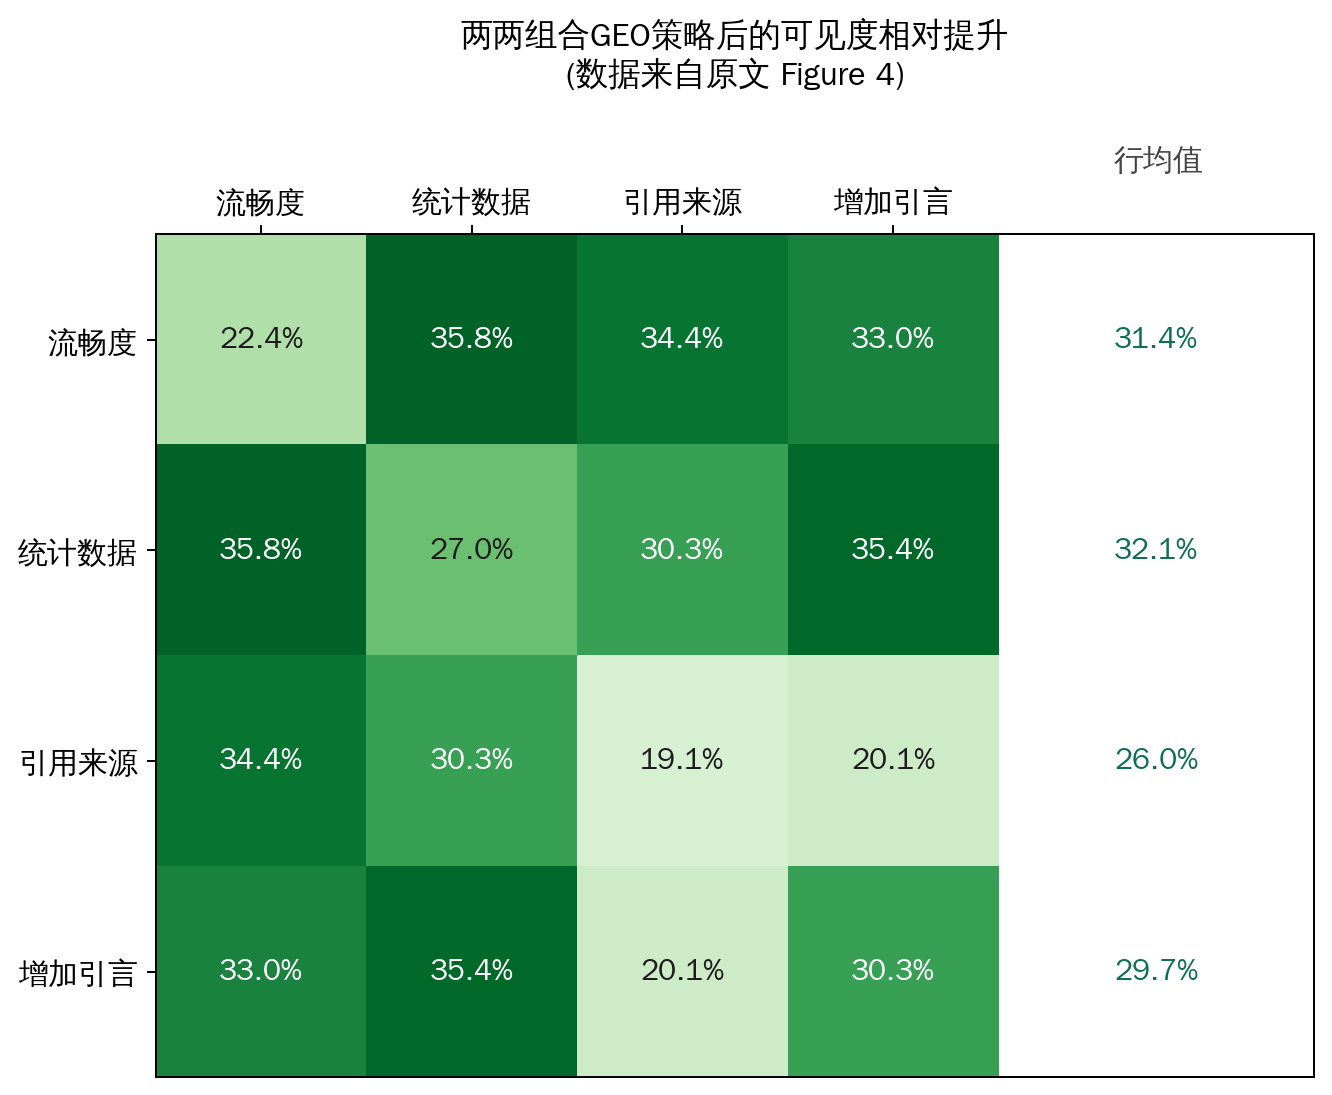
Ce graphique a été redessiné à partir des données de la Figure 4 de l’étude. Plus la couleur est foncée, plus le gain de la combinaison est élevé.
À quoi ressemblent les exemples concrets ?
L’étude présente plusieurs exemples parlants dans le Tableau 4. Les trois cas correspondent à la citation de sources, à l’ajout de statistiques et au renforcement de l’autorité. Ils ont un point commun : de très petites modifications produisent des gains de visibilité considérables. Ajouter simplement une référence à un organisme d’étude après une affirmation sur la consommation de chocolat par habitant en Suisse accroît la visibilité de 132,4 %. Compléter une phrase sur le remplacement du travail humain par des robots avec un pourcentage de croissance précis apporte 65,5 %. Reformuler un constat sur le bilan sportif d’une équipe de façon plus affirmative et en soulignant ses acquis produit 89,1 %. Ces exemples montrent que l’optimisation GEO ne nécessite souvent pas de créer de nouveaux contenus, mais simplement d’ajouter une source, un chiffre ou d’ajuster le degré d’assurance d’un texte existant. Elle reste donc très accessible aux créateurs ordinaires.
Au-delà du laboratoire : validation sur Perplexity.ai
Pour montrer que ces résultats dépassent le cadre d’un prototype de laboratoire, les auteurs ont appliqué les mêmes méthodes à un moteur génératif réellement déployé et utilisé à grande échelle, Perplexity.ai. Comme Perplexity.ai ne permettait pas de désigner directement les URL sources, les textes ont été fournis sous forme de fichiers, avec l’instruction de répondre uniquement à partir de ces fichiers. L’évaluation porte sur un échantillon de 200 requêtes, présenté dans le Tableau 5.
|
Méthode |
Mots pondérés par la position |
Impression subjective |
|---|---|---|
|
Sans optimisation (référence) |
24.1 |
24.7 |
|
Accumulation de mots-clés |
21.9 |
28.1 |
|
Ajout de citations textuelles |
29.1 |
32.1 |
|
Ajout de statistiques |
26.2 |
33.9 |
Les résultats concordent fortement avec ceux du laboratoire : l’accumulation de mots-clés reste défavorable pour les mots pondérés par la position, avec environ 10 % de moins que la référence, tandis que l’ajout de citations textuelles et l’ajout de statistiques continuent de se distinguer parmi les stratégies qui renforcent la crédibilité du contenu, avec des gains d’environ 22 % et 37 % respectivement. Ce résultat a trois implications : il confirme la nécessité de méthodes conçues pour les moteurs génératifs ; il montre leur capacité à se généraliser entre produits, sans dépendre d’un moteur expérimental particulier ; et il indique que les créateurs peuvent appliquer directement ces stratégies simples pour obtenir des bénéfices concrets dans des produits réels.
Situer cette recherche dans un contexte plus large
L’étude distingue son apport de trois catégories de travaux antérieurs :
- Génération de réponses étayées : des systèmes comme WebGPT entraînent les modèles à naviguer sur le Web et à produire des réponses appuyées sur des sources, tandis que d’autres méthodes génèrent des réponses à partir de résultats de recherche. Le GEO ajoute à ces systèmes un cadre d’évaluation unifié. Et contrairement à un travail récent sur la manipulation des recommandations de LLM par des textes adversariaux pour accroître l’exposition de produits, il propose des stratégies d’optimisation non adversariales applicables au contenu de n’importe quel site.
- Génération augmentée par récupération : des travaux comme RAG et REALM visent surtout à remédier aux limites de mémorisation des connaissances par les modèles de langage. Le périmètre des moteurs génératifs est plus large : ils doivent produire des réponses tout en indiquant les sources, et accomplir un ensemble de sous-tâches comme la reformulation des requêtes et la sélection des sources. Ils ne se limitent donc pas à la récupération d’information.
- SEO traditionnel : les recherches SEO des 25 dernières années se répartissent entre optimisation sur site, pour améliorer le contenu et l’expérience, et optimisation hors site, pour obtenir des liens entrants et renforcer l’autorité du domaine. Cette logique suppose toutefois que le moteur associe des mots-clés. Elle s’applique peu à un environnement piloté par des modèles génératifs qui dépasse cette correspondance : c’est précisément la raison d’être du GEO.
Conclusion et limites
En résumé, cette étude apporte trois contributions : une définition formelle des moteurs génératifs, le premier cadre GEO d’optimisation destiné aux créateurs pour les moteurs génératifs — avec des indicateurs de visibilité et 9 stratégies concrètes —, ainsi que la création et la publication en accès ouvert du jeu de référence GEO-bench. Son constat principal est que des modifications renforçant la crédibilité — références, citations textuelles et statistiques — peuvent accroître jusqu’à 40 % la visibilité d’un site dans les réponses génératives. Les stratégies efficaces varient selon les domaines ; leurs combinaisons fonctionnent généralement mieux que leur usage isolé ; et les petits sites mal classés en bénéficient particulièrement. C’est un signal encourageant pour les créateurs indépendants et les sites de petite ou moyenne taille.
Les auteurs exposent aussi plusieurs limites. Premièrement, les moteurs génératifs évoluent rapidement : comme le SEO au cours de son histoire, les méthodes GEO devront probablement être adaptées en continu. Deuxièmement, malgré les efforts pour représenter les usages réels, la nature des requêtes change avec le temps et GEO-bench devra être régulièrement mis à jour. Troisièmement, les algorithmes de classement étant opaques, l’étude n’évalue pas l’incidence possible des modifications GEO sur le classement traditionnel. Les auteurs estiment cet effet limité, car leurs modifications portent principalement sur le texte, sans toucher au domaine ni aux liens entrants. Enfin, l’allongement du contexte des modèles permettra aux moteurs d’exploiter davantage de sources, ce qui pourrait réduire encore l’importance du rang dans les résultats de recherche. Dans l’ensemble, cette étude pose les bases d’un nouveau domaine : son cadre, ses indicateurs et son jeu de référence doivent permettre aux recherches suivantes de progresser sur un socle commun.